Open Social Web and Large Scale Social Technologies

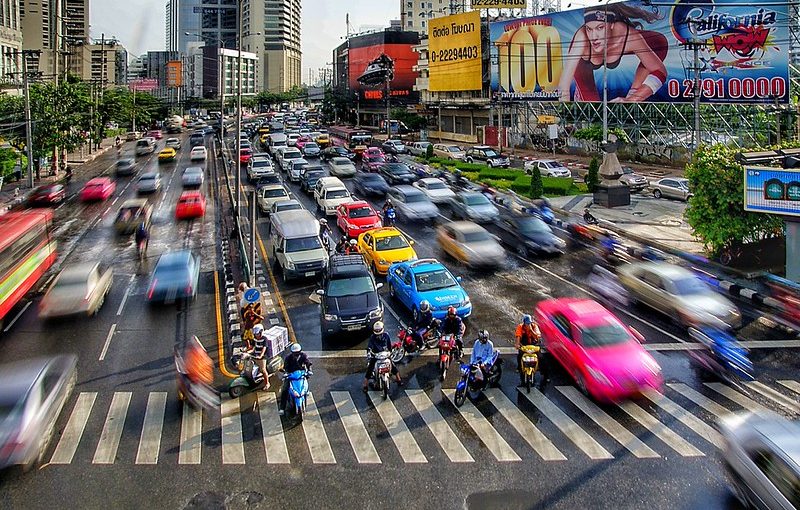
In 2017, BBC aired a wonderful nature miniseries about animal swarms. It struck me that humans too gather up in large groups, and it is quite surprising that we successfully manage the complexity of large groups. However, when we actually swarm, it is not a pretty sight. It looks like this

Rush Hour in Bangkok, in Public Domain by Bernard Spragg

Humans often engage in swarm behaviour, while lacking swarm intelligence.

Even though new directions in the development of open social web technologies show great promise, ultimately, social technologies should enable us to gain swarm intelligence, and I don’t see how that would happen with the technologies that are on the table. I’d like to bring this discussion up, and also make somewhat technical at the end.

So, lets start with the above picture and state a possible mission: Halve the number of cars on the road, while keeping in mind that the transit system as a whole has a number of equilibrium points. So, for example, it is well-known that if you build a new highway, or add another lane, as is commonly done, the result is basically that you just interrupt the equilibrium between transport alternatives: If it is faster to go by car than the train, you go by car, until the roads are so congested that the travel time is about the same. Adding another lane is likely to make the car faster until and so people will prefer the car to the train for a while until the roads get congested again. So, basically, to make roads faster above a certain density, improve rapid transit, not roads. I felt the need to state this as part of the mission description, because you could trivially make it nice to share cars, but that too is likely to just end up finding new equilibriums, not add swarm intelligence.

So, recall that this was the promise of self-driving cars. It is not particularly that it would be nice to sit back while the car was driving, it is really that far fewer cars would be needed for transport needs. However, as cool as it may be, it is really about shared mobility, self-driving is not required to achieve that, and also, without shared mobility, self-driving as just another cool gadget.

Actual shared mobility requires swarm intelligence to provide significant benefit for humanity, and most certainly, it is a solution to problems that are very significant, pollution, accidental deaths, waste of time, loss of economic opportunity.

The problem to be addressed is pretty hard, and so, lets not go into every detail, but I think we can safely say that part of the solution would be social technologies, and that individuals would need to share intents and provide situational awareness, expressed in data that is to a great extent personal.

Infrastructure for such technologies would likely require query and inference over all this data, and here lies the key to what I worry about with open social web technologies, it seems very focused on the data management needs of individuals, which, I acknowledge, is extremely important. Without taking back the agency that has been stolen from people, no responsible development is possible.

As part of this, a great deal of decentralisation is required, both technological and institutional. Decentralisation must also be in service of the collective good, because, if not, it is not really social, is it?

Decentralisation of technology is usually hard. It is almost always easier to just gobble up data into a bunch of datacenters and perform the required query, training and inference over them there. It is therefore not just about the protocols and the social media use cases, social technologies must also consider the large scale use cases that can and will happen downstream from the ecosystems that we currently build. And I’m very concerned about these downstream uses, because I see them as a very strong choke point for sentralisation, a centralisation that can not only undermine what we do or make it evil, but also turn governments against us.

Just think about what could happen if a big data gobbler presented a prospect to the government that they would halve the number of cars on the road, if they only relaxed privacy regulations around position data, and added a bit of biometrics here and there. It’d be difficult to say no, given the severity of the problems.

My hunch is that to avoid it being such a centralisation choke point, we would need to make it possible to query and inference over data without having an architecture that requires a firehose that enables gobbling. Data should stay where they are, query plans should match data where they are and only project data that is required to help the swarm.

My problem is that I just don’t see how that would happen now, but I did see how it could happen with Solid if it wasn’t just about enterprise use cases. It wouldn’t be easy, it would be really, really hard, but I could see a way with things done to the protocol, with metadata, with new authorization scopes that could grant access to metadata even when data would require a more restrictive scope. However, the query and inference was strongly dependent on the simplicity of the underlying data model, basically just n-tuples with a very small n, where ontologies can add a bit to help.

Anything more advanced that than, and the feasibility of doing it decentralised seemed to vanish. A case in point, there were quite a few attempts to build database engines on the Topic Maps data model, and even a centralised database was hard to scale significantly. I don’t see how you would could build it on the IPLD data model, and there’s little to indicate that IPFS would help with the necessary decentralization.

What I currently see are two possible failure modes, one is that it becomes so valuable to do query and inference over many PDSes, so that the PDS provider with the most PDSes win (which, basically is how Solid got destined to fail, the community had zero attention around how hard decentralization is, and Inrupt simply didn’t want it), and the other is that we end up with the firehose gobbled up into a big centralized, cloud based system for processing. For that not to happen, I think we need to be able to perform queries and inference over data where they are, possibly with some replications, like IPFS originally intended, but replication over real-time, or near real-time data is hard.

Now, I’m trying not to make an argument from ignorance here, and it is certainly not an argument from authority, because I have only rudimentary understanding of several of the technologies in place, but I just don’t see a discussion of such issues. And somewhere down the road, I think the large-scale social coordination problems is really to key for social technologies to be more than a footnote, the failure of the 2010s.

Dumbphones – Det handler om makt

Dumbphones har blitt en stor greie blant dem som ikke liker Big Tech. De som fÞlger bloggen vet at jeg er sterk motstander av Big Tech, men det er stÞrre spÞrsmÄl som ligger bak som jeg mener er viktigere, mye viktigere, hvis man skal klare Ä frigjÞre seg fra Big Tech. Man mÄ tenke pÄ hva slags makt som ligger i devicene, det er det aller viktigste. I en dumbphone ligger all makt i det ene selskapet som lager dumbphonen. De har helt ubestridt, eneveldig makt. Det betyr at hvis dumbphones skulle bli populÊrt igjen, sÄ har de ogsÄ makten til Ä bestemme hva en dumbphone kan gjÞre, og da kan du vÊre sikker pÄ at dumbphonen ikke vil vÊre pÄ din side. En dumbphone er ogsÄ det vi kjenner i informatikken som en Turing-maskin, den har de samme egenskaper som alle andre datamaskiner, det er ingen teoretiske begrensinger pÄ hva dumbphonen kan programmeres til Ä gjÞre (utover sÄnne ting som at hvis den bare har hardware til Ä vÊre en 4G-telefon kan den neppe programmeres til Ä bli en 5G-telefon), det handler bare om hvem som har makten til Ä gjÞre det. AltsÄ, med en dumbphone gir du total makt til ett selskap. Var det virkelig det du Þnsket Ä gjÞre?

FÞrst mÄ man sikre at man ikke blir tvunget til Ä bruke Big Tech sine plattformer, sÄ kan man sikre at man ikke bruker det dÄrlige, avhengighetsskapende.

Med en iPhone ligger ogsÄ nesten all makt i hendene til Apple, men det er mulig Ä komme inn med litt andre ting, i form av apps. Det er ikke en sÊrlig stor forbedring, men det er litt.

Med Android er situasjonen litt bedre, det er en litt mer Äpen plattform, men posisjonen Google har pÄ plattformen er meget sterk, de reserverer mesteparten av makten til seg selv, men det er en del muligheter for Ä andre Ä innovere. Ingen stor trÞst, men makten til Google er betydelig mindre over Android, enn det er til produsenten av dumbphonen.

En smartphone burde egentlig vĂŠrt en device for General Purpose Computing. General Purpose Computing er egentlig en frigjĂžrende teknologi, den kan brukes til hva som helst. Problemet er at demokratiet aldri har tatt dette pĂ„ alvor, fordi samfunnet aldri har prĂžvd Ă„ forstĂ„ hva General Purpose Computing betyr for samfunnet. Det er dette som er det virkelige problemet. Å gĂ„ tilbake til dumphones er Ă„ oppgi General Purpose Computing, en frigjĂžrende teknologi, for Ă„ gĂ„ til en svĂŠrt begrensende teknologi som er under autoritĂŠr kontroll. Det er Ă„ rette baker for smed. Man har ikke en god nok forstĂ„else av makt i sosioteknologiske systemer. General Purpose Computing gjĂžr at ogsĂ„ avhengighetsskapende teknologier kan lages, men det gjĂžr ogsĂ„ at man kan lage alternativer som ikke er det. Problemet er at vi ikke har noen motmakt som gjĂžr at befolkningen har tilgang til teknologi som er bra for dem, ikke smarttelefonen som sĂ„dan.

SĂ„, hva er alternativene? Det handler om Ă„ analysere makten og hva som kan forandre maktforholdene. Det handler ikke mest om produkter. Jeg vil sterkt anbefale alle om Ă„ lese om Digital Commons. Digital Commons er en modell for Ă„ styre teknologiutvikling som allerede er vel etablert, men som trenger sterkere utbredelse og anvendelse i flere situasjoner.

Jolla er et finsk selskap som lager telefoner med et annet operativsystem enn Android. Med Jolla har demokratiet mulighet til Ă„ komme inn og etablere en Digital Commons styringsmodell, der er en av aktĂžrene.

Hvis dette blir for radikalt, sÄ kan man ta de fleste Android-telefoner og installere alternative operativsystemer, som GrapheneOS, Lineage OS eller /e/ OS.- Alle disse er delvis styrt som Digital Commons i dag, og demokratiske myndigheter har mulighet til Ä etablere nye styringsstrukturer ved Ä bidra inn i disse Þkosystemene. Hvis jeg skulle kjÞpt en ny mobil i dag, ville jeg helt konkret ha kjÞpt en Fairphone 6 med /e/ OS preinstallert. Da fÄr man en telefon med hÞy kvalitet som kan repareres enkelt hjemme, uten Big Tech-bindinger, som gjÞr en stor innsats for Ä gjÞre produksjonen pÄ en etisk mÄte, samtidig som den kan kjÞre det meste av det man trenger i hverdagen.

Det er en mulighet til, nemlig PureOS, der en er en av utviklerne er en dansk kamerat av meg. Dette kan kjĂžpes i et veldig amerikansk produkt som heter Librem 5, som selv om det er amerikansk, laget med svĂŠrt stor respekt for enkeltmenneskets rettigheter. Igjen, jeg mener dette ikke bĂžr handle om amerikansk eller ikke, kinesisk eller ikke, og heller ikke om dumbphones eller ikke. Det bĂžr handle om hvordan makten forvaltes. Og der er dumbphones en dum ide (det var ikke jeg som begynte Ă„ bruke ordet “dum”, ikke sant?), det finnes langt bedre tilnĂŠrminger.

Mens vi er inne pÄ dumbphones, jeg skjÞnner virkelig ikke hva folk ser i SMSer. SMS var en mÄte der de mektige pÄ den tiden, produsenter og teleoperatÞrer, misbrukte sin makt til Ä flÄ folk. En krone eller mer per SMS var det vi betalte! For en tjeneste som hadde en marginalkostnad pÄ omtrent ingenting. Og det er derfor den er bakt inn i abonnementet nÄ. Hele sikkerhetsmodellen rundt SMS er en katastrofe, SMS er ikke kryptert, kan enkelt overvÄkes, og avsender kan enkelt forfalskes. Derfor, det med Ä sende koder pÄ SMS, ingen god ide, men det gjÞres likevel. Bruk Signal istedet! Det er nettopp slik total mangel pÄ respekt for folks rettigheter og sikkerhet som skjer nÄr man samler makt i sÄ fÄ hender. Big Tech har bare gjort dette problemet verre, men det er egentlig det samme problemet.

Jonathan Haidt and the New Techno-Solutionism

I wanted to agree with Jonathan Haidt, because I share many of his views of what went wrong, how current social media is detrimental to not only teen mental health, but to a wide array of societal functions. His solutions, however, will most likely further cement the current powers and lead to more social ills, not less. Furthermore, he has had such an impact that it is difficult to speak about more comprehensive solutions to the problems. It had been easier to just try to ride the wave that Haidt set in motion, but it is fundamentally flawed in so many ways that I must rather speak up.

We are all captives of feudal lords who do not have our best interests in mind, but who have created a failed state, with many harms that follow.

I have not been able to get my hands on The Anxious Generation, but Haidt has elaborated on his views in several podcasts, on “Your Undivided Attention” and on the Ezra Klein Show. Haidt prescribes four norms:

  1. No smartphone before high school.
  2. No social media until 16.
  3. Phone free schools.
  4. Far more independence, free play, and responsibility in the real world.

I wholeheartedly agree with number 4, I’ll get back to that later. I can also generally support number 3. As of today, seen in isolation, it is easy to make the case for the first two also, but it completely misses the point.

The extent to which the point has been missed lies in the rhetorical question that Haidt posed with emphasis in both podcasts:

At what age are you old enough to sign a contract with a giant corporation to give away your data and your rights and let them stuff stuff into you chosen by their algorithm? At what age?

I’m astonished that the neither he nor the hosts attempted to give the only reasonable answer to this question: No-one should ever be compelled to sign that contract under any circumstances! That there are powers in society that can compel people to do that is one of the central dysfunctions in society, that is what leads to ills such as a floundering public debate, information disorder, innovation stagnation, poor mental health, lack of attention to issues that matter, etc., etc. At least do not make it worse, but the task before us is really to challenge that power. These companies are the abusers!

Haidt is not willing to do that, to the contrary, he celebrates an Australian approach (which is now also misguidedly proposed in Norway) which grants the power to collect the data to the very giant corporation that is abusing the teens to begin with! So, now it is not only by contract, now the law will force people to share data with those corporations. What could go wrong?

A well-known example that happened long ago: The cookie-banners we all have to click through every day have been used to undermine human agency by conditioning us to consent to anything. And it is not like third party cookies weren’t known to be a terrible idea: In the first standards document from 1997, it was treated as a security problem. Every law on the books have the potential to be abused, like they did with consent. With the naive Australian approach, which Haidt celebrates, the law will be used for nefarious purposes, it will clearly be used to extract much more data, because, of course, there will never be a very reliable way to assess someone’s age from just a few attributes. A less naive way to do age verification is to rely on government attestation, you can even make a system that only gives a yes/no answer. However, that does not challenge the fundamental causes of harm, that there exists entities that are so powerful that they can compel you to turn over your rights. It can also cause new harms, since it is not just kids who will need to give up data, everyone has to, which can have chilling effects on freedom of expression.

The two first norms are just techno-solutionism in a new wrapping. The belief that if you just let loose technologists, technology will emerge as a cure to the problems you see, is still surprisingly prevalent. Age limits, that require a technological quick-fix in the form of age verification, is just yet another round of techno-solutionism, albeit coming from other sources this time.

There are several misunderstandings that have to be addressed. The first, I think is that current social media is so entrenched that it is hard to get out of our lives. My assertion is that it is much easier to topple the giants than to design a responsible age verification system. But first, another misunderstanding is around the “screens”. When people talk about screens, they talk as if there is a screen that causes all the ills. It isn’t. If you are to understand technology, the first thing is to break it down to components and understand what each component does, only then is it possible to intervene sensibly. A screen is a device that displays red, green and blue dots. That’s all. It has very little, if any impact. The things that should be of concern are elsewhere, usually, they are not even on your phone or on your computer at all. Haidt’s focus on screens have been strongly detrimental to public discourse, it has become very difficult to talk about the deeper problems.

Now, recall what legacy social media platforms actually are: They are surveillance and influence machines. The parts that are actually in some cases socially useful, the part where we can debate each other and coordinate with other parents in school are tiny bits. Those parts are just there to trap us, it is just there for exploitation. To replicate their function is no big deal, it can be done in a matter of weeks. Haidt calls these surveillance and influence machines a “miracle of technical innovation”, to which I disagree very strongly. These have no societal function, if they disappeared, we would need different ways of bringing products to market, but there would be no loss.

Obviously, we should have much higher ambitions for social media. Social media should first of all enhance our capability for coordinated action, it should provide us with a much more deliberative democracy, it should bridge our narratives and bring people closer together. It should be good for our mental health. Martin Seligman mentioned a meeting with technology companies in his 2011 book “Flourish”:

I commented on Facebook’s possibilities for instilling well-being: “As it stands now, Facebook may actually be building four of the elements of well-being: positive emotion, engagement (sharing all those photos of good events), positive relationships (the heart of what ‘friends’ are all about), and now accomplishment. All to the good. The fifth element of well-being, however, needs work, and in the narcissistic environment of Facebook, this work is urgent, and that is belonging to and serving something that you believe is bigger than the self — the element of meaning. Facebook could indeed help to build meaning in the lives of the five hundred million users. Think about it, Mark.”

Those present chose to do the opposite, but it was a choice. Social Media as it is now was not inevitable. We can make a different choice.

Haidt celebrates TV, and again I disagree strongly. At its worst, TV is a pacifier, TV cannot build engagement and positive relationships in individuals. It plays no role in accomplishment, is a venue where narcissists get more exposure than what is good for them, and meaning is hard to make out of it. It cannot help to build bridges between individuals with differing opinions. Also, consider Carl Sagan’s remarkably prescient book “A Demon-Haunted World” from 1995:

I have a foreboding of an America in my children’s or grandchildren’s time — when the United States is a service and information economy; when nearly all the key manufacturing industries have slipped away to other countries; when awesome technological powers are in the hands of a very few, and no one representing the public interest can even grasp the issues; when the people have lost the ability to set their own agendas or knowledgeably question those in authority; when, clutching our crystals and nervously consulting our horoscopes, our critical faculties in decline, unable to distinguish between what feels good and what’s true, we slide, almost without noticing, back into superstition and darkness. The dumbing down of America is most evident in the slow decay of substantive content in the enormously influential media, the 30 second sound bites (now down to 10 seconds or less), lowest common denominator programming, credulous presentations on pseudoscience and superstition, but especially a kind of celebration of ignorance.

At its best, then certainly, I too enjoy a good Pixar movie with my kids and talk about it afterwards. I just can’t follow Haidt in elevating something as passive as TV to contrast with what social media could be. It is purely misplaced nostalgia, as the quote from 1995 shows.

Social media could play a role in getting kids out again. I strongly agree that it is critical that they do. I also exchanged a few emails with Haidt’s cofounder of Let Grow, Lenore Skenazy, because here in Norway, it was just a short period in the 90-ties that we had the same panic as in the US. Playgrounds would be sterilized and the lower branches of trees would be cut to keep kids from climbing them. Gen Z has not been subject to that madness here in Norway. Norway is different, it shows in advertising and in that the host of a popular TV show reminds kids that they have the right to jump in icy water in school. While visiting New York City, my kids laughed at the idea that someone their age shouldn’t be allowed to ride the subway on their own. And still, they do appear to be as much victims to deteriorating mental health as their US peers. That may be because they aren’t out as much as I was at their age, but it is not due to parenting or societal pressures. It seems to me that the US got liberty all wrong: You shouldn’t need to enact free-range kids laws, kids’ right to roam should be a part of the liberty that everyone is afforded and that right shouldn’t be infringed upon. That’s how it is here in Norway.

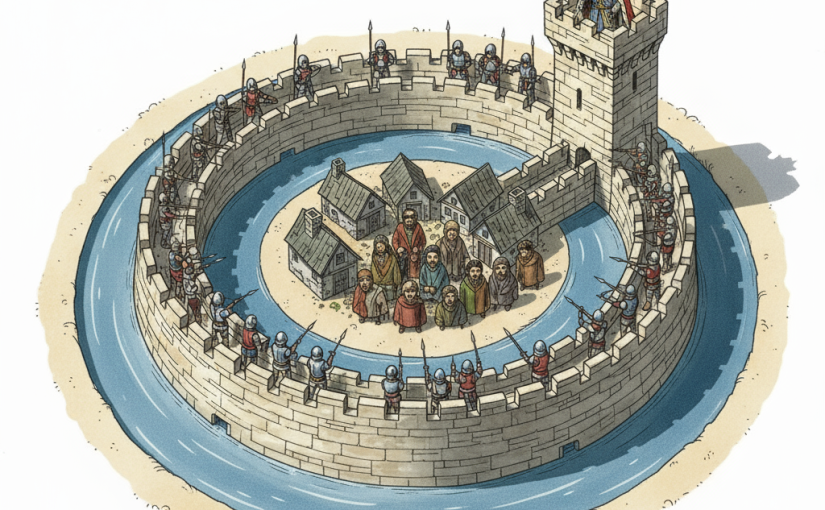
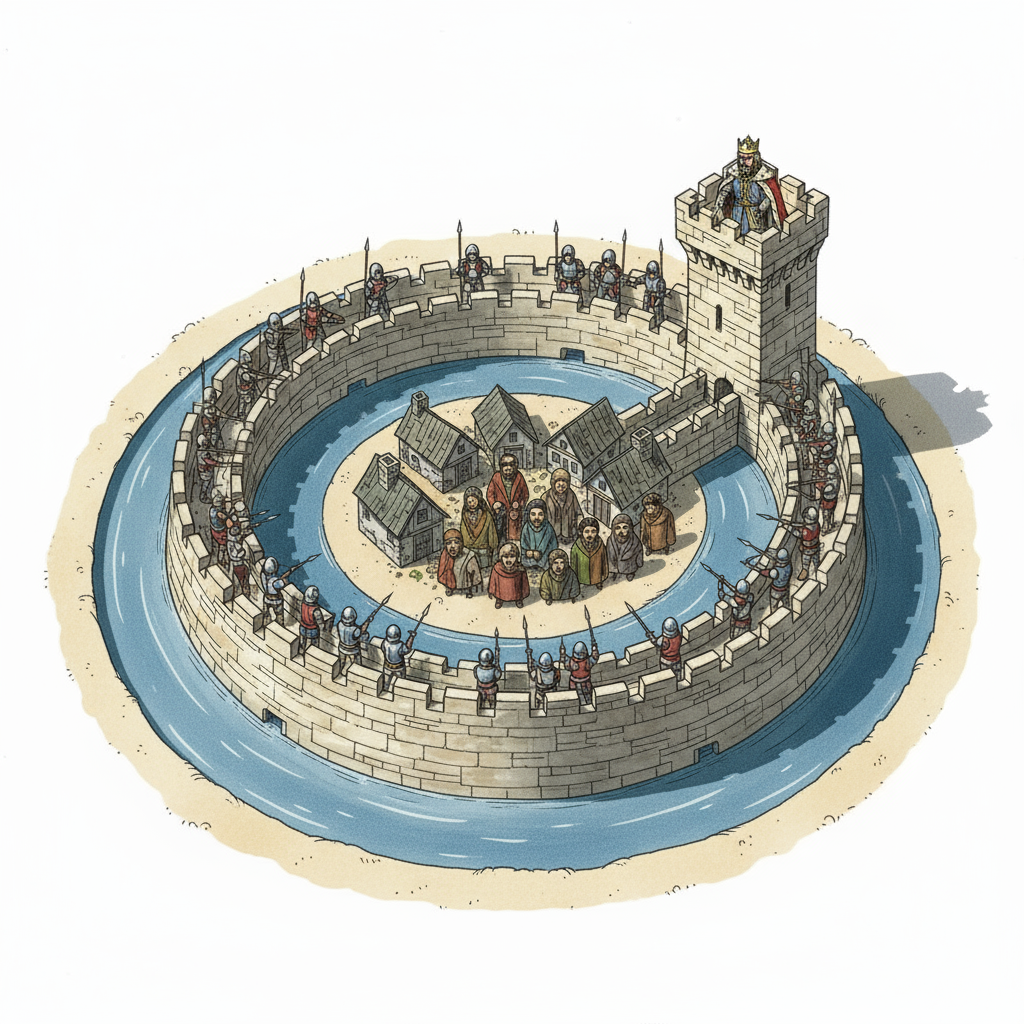
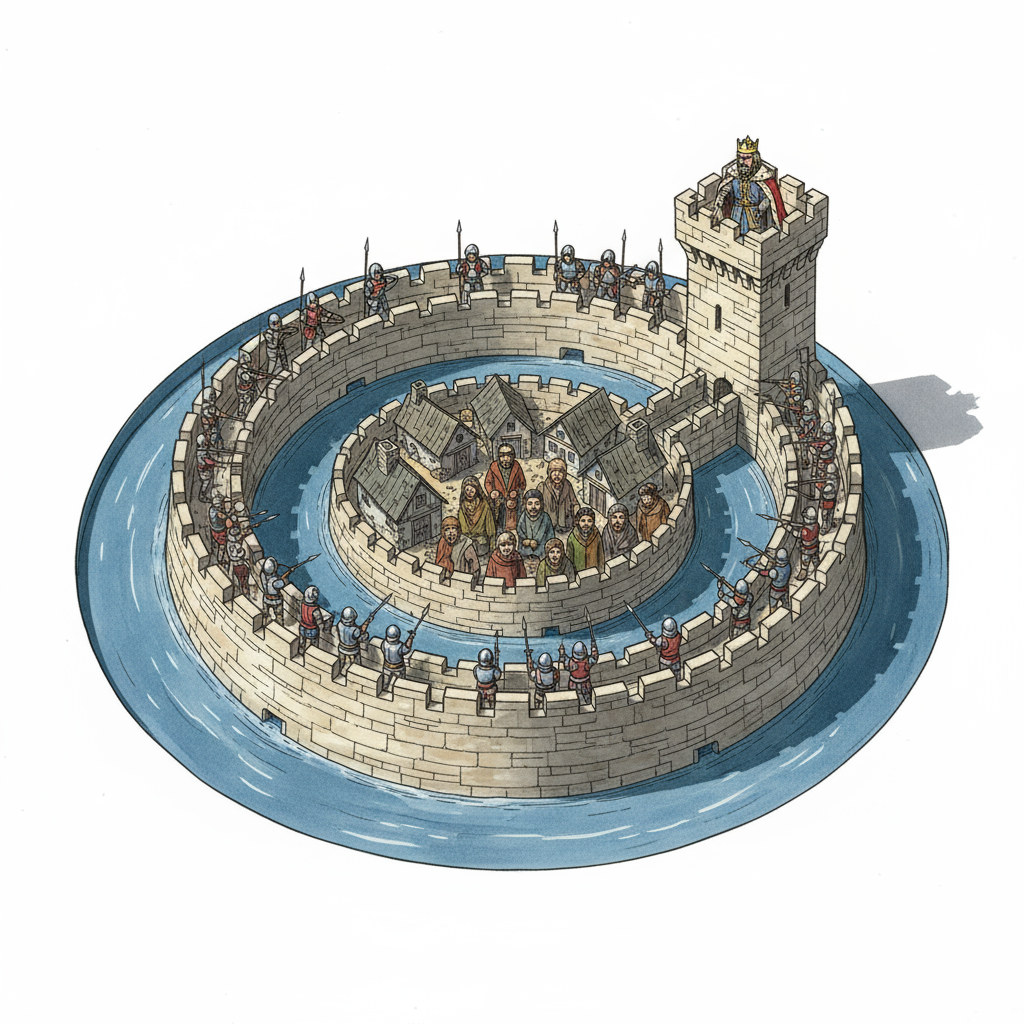
Which brings me to another bizarre idea in this debate: That it is appropriate for the state to direct its power against their own citizens, that it is appropriate to regulate the behavior of victims and not their abusers. Changing social media must be an emancipation project. Tech giants have taken essential liberty from the people, and democracy must return liberty to the kids in particular and to the people in general. It must again make it possible to innovate. The reality of the matter is that innovation is just an empty buzzword in Silicon Valley, what they actually build is literally “moat“. This is how social media will look with the proposed regulation:

Erecting another wall around the victims of the abuse will not be helpful.

As a technologist, I reject techno-solutionism. I call on media studies to similarly understand that media literacy programs do not by itself help and policy makers to similarly realize that only writing down regulation and expect it to be followed is not the solution.

That is not to say that technology isn’t part of the solution. It is, but some technology must be developed but with a democratic mandate rather than just a commercial one. Crucially, it must not be just about the technology, but about the new societal institutions we require, where governance and technology development come together in large international ecosystems, guided by cross-disciplinary teams. Surely, it is much harder to set up, but not as hard as you may think. Digital Commons is already available for essential infrastructure, and various initiatives begin to emerge. The first feature of new social media must be to enable collective action, and using that, it must bring together many parties around a common goal of creating social media that are truly liberating.

Now, it may be that age verification can be done well within new social media. It may be that age limit is a reasonable approach at that point to certain problems. However, I would much rather see children and parents coming together over a shared understanding and morality of what is needed for kids to flourish and build their shared rulesets based on that.

Politisk reklame hos Meta

Ny valgkamp — mer politisk reklame pĂ„ Facebook og andre Meta-plattformer. Men brukes personopplysninger, og er reklamen i det hele tatt lovlig? Og hva har det Ă„ si for demokratiets forhold til teknologiselskapenes makt?

Ved kommunevalget i 2023 fulgte Dagsavisen opp partienes bruk av Facebook og fant at en rekke partier var pĂ„ kant med lovgivningen. Siden det har Meta strammet inn reglene for politisk reklame, nĂ„ mĂ„ partiene annonsere i en Special Ad Category. De mĂ„ videre indikere at at annonsene er i en kategori for “samfunnsspĂžrsmĂ„l, valg eller politikk”. Denne kategorien omtales gjerne som SIEP-annonser. NĂ„r denne kategorien er valgt begrenses annonsĂžrens muligheter til mĂ„lretting, i praksis til geografi.

Betyr dette at den politiske reklamen ikke er atferdsbasert? Betyr det at den ikke bruker personopplysninger?

Nei, mener jeg. Jeg mener at all reklame hos Meta er atferdsbasert. Men som teknologigiganter flest er ikke Meta interessert i klare svar, men la oss se pÄ hva vi har Ä gÄ pÄ.

La oss fÞrst se pÄ hvordan Meta selv beskriver algoritmene. Meta har en overfladisk beskrivelse av hvordan de bruker maskinlÊring (som er en dominerende retning i AI). I grove trekk sier den at annonsÞren fÞrst velger mÄlgruppe. NÄr en bruker skal se en annonse lager sÄ systemet en liste med alle annonser som brukeren er i mÄlgruppen til. Disse gÄr sÄ inn i en auksjon, en auksjon som bestemmer hvilken av annonse brukeren skal fÄ se.

I denne auksjonen gjÞres flere beregninger, der hvor mye annonsÞren er villig til Ä betale, hvor hÞy kvalitet annonsen har. De prÞver sÄ Ä estimere hvor sannsynlig det er at brukeren skal gjÞre som annonsÞren vil: KjÞpe en ting, installere en app, eller stemme pÄ et bestemt politisk parti?

Eller er SIEP-annonser unntatt fra denne prosessen?

AltsĂ„, det er ingen hemmelighet at i denne prosessen bruker personopplysninger. Det er nettopp dette som er atferdsbasert markedsfĂžring. Dette bruker data fra atferd bĂ„de av og pĂ„ Facebook og Instagram. Dette bruker ogsĂ„ data fra offentlige nettsteder. Det er en alvorlig misforstĂ„else at man kan “slette Facebook”, Facebook er overalt, det er ikke en app eller et nettsted, det er en allestedsnĂŠrvĂŠrende infrastruktur. Dette er den sagnomsuste Algoritmen (et begrep som blir brukt altfor mye).

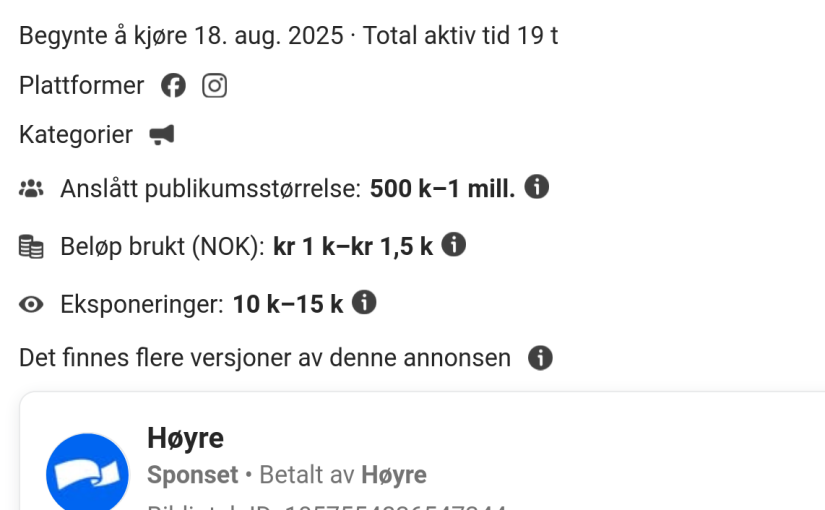
La oss se pÄ annonsedetaljene til en konkret annonse. NÄ ble det HÞyre, fordi jeg har sett flest annonser fra partiet HÞyre, men jeg Þnsker ikke henge ut noen spesielt, de fleste annonserer pÄ Meta og alle er like.

Skjermdump av en tilfeldig valgt annonse for HĂžyre.

Man kan klikke pĂ„ i-ene ved siden av de forskjellige tallene for Ă„ fĂ„ videre forklaring. “AnslĂ„tt publikumsstĂžrrelse” er altsĂ„ “target audience”, det er det publikum annonsĂžren selv velger. Vi ser med en gang at “Eksponeringer”, altsĂ„ hvor mange ganger annonsen er vist, er mye lavere.

Partiene mÄ kunne svare pÄ hvordan man gÄr fra publikumsstÞrrelse til eksponeringer. At man kun har mulighet til Ä mÄlrette basert pÄ geografi betyr ikke at det ikke brukes personopplysninger i mÄlrettingen, det er bare at det er Meta og ikke partiene som mÄlretter. Jeg har sendt en mail til HÞyre med det spÞrsmÄlet, de har ikke svart.

Er det noe i Meta sin dokumentasjon som tyder pÄ at SIEP-annonser er unntatt fra auksjonen? I sÄfall kunne det kanskje tyde pÄ personinformasjon ikke ble brukt. Jeg har sett og ikke funnet noe som tyder pÄ at det er noe annet som foregÄr for SIEP-annonser enn andre annonser. Du kan klikke pÄ i-ene og forklaringstekstene, hvis du gjÞr det kommer du til nÞyaktig den samme dokumentasjonen som for annen markedsfÞring. Denne dokumentasjonen er mest opptatt av at antall eksponeringer er nÞyaktig, den er der for Ä vise at annonsÞren fÄr valuta for pengene, ikke for Ä forklare overfor samfunnet forÞvrig hvordan markedsfÞring fungerer.

Alt tyder altsÄ pÄ at politisk reklame hos Meta er atferdsbasert, at den misbruker personopplysninger og at den er lagd for Ä maksimere sannsynligheten for at brukeren stemmer pÄ et bestemt politisk parti.

Denne reklamen har ikke som formÄl Ä sikre en opplyst offentlighet. Den har ikke som formÄl Ä opplyse velgerne. Det betyr ikke at reklamen har slagside mot et politisk parti, men det er noe vi har svÊrt lite mulighet til Ä etterprÞve.

Det virker som partiene ikke forstÄr at de bruker atferdsbasert markedsfÞring, det virker som det er en utbredt misforstÄelse at hvis man ikke mÄlretter eksplisitt, sÄ er ikke personopplysninger involvert. Men den mÄlrettingen som gjÞres eksplisitt handler kun om target audience, og reflekteres kun i publikumsstÞrrelse. Personopplysningene kommer inn i auksjonen, og auksjonen foregÄr alltid. Det virker som Meta er interessert i Ä tÄkelegge dette mest mulig.

Jeg skal innrÞmme at det vil vÊre vanskelig Ä overbevise meg om noe annet, selv om Meta skulle komme ut og avvise det. Det vil vÊre omtrent umulig for en revisor Ä sjekke hva dette systemet faktisk gjÞr, og dette er det eneste konkurransefortrinnet Meta har. De har alt Ä vinne pÄ Ä holde dette tÄkelagt, og ingen som kan holde dem ansvarlig hvis dette systemet gjÞr skade.

Dessverre har dette ogsĂ„ mye Ă„ si for hvordan industrien reguleres, i Digital Services Act, §26 er det forsĂžkt: At man skal ha tilgang til “main parameters”, og Meta tolker selvfĂžlgelig bestemmelsen til bety at annonsĂžrens target audience mĂ„ identifiseres for alle annonser, noe de har gjort lenge. SĂ„ lenge de fĂ„r tĂ„kelegge hva som faktisk skjer i auksjonen er det usannsynlig at regulering vil virke.

Hvis demokratiet skal lykkes Ä balansere makten til teknologigigantene kan man ikke sÄ tydelig gÄ i fellene de setter, da avslÞrer man bare at man er avhengig av deres tjenester og at man heller ikke forstÄr dem tilstrekkelig til Ä regulere.

Fyll igjen vollgravene!

Det er ikke bare OpenAI som har hatt problemer med Ă„ etablere forsvarsverket, slik Dag Mostuen Grytli noterer i Morgenbladet. I fjor lekket et notat fra Google med tittel “We Have No Moat, and Neither Does OpenAI”. Siden har begge selskaper vĂŠrt aktive med Ă„ grave vollgraver, og det ser ikke bra ut for samfunnet, men dokumentet gir oss ogsĂ„ en mĂ„te Ă„ sikre demokratisk kontroll og innovasjonsevne pĂ„, men da mĂ„ veldig mange lĂžse trĂ„der bindes sammen.

Forfatteren bak notatet mener at Ă„ konkurrere direkte med “Open Source” kommer til Ă„ feile, og at de i stedet bĂžr lage en strategi for Ă„ dominere “Open Source”. Men hva er sĂ„ “Open Source”? Og hvorfor er det sĂ„ kraftig at det kan fylle vollgraven for Google og OpenAI?

Open Source og Free Software

For Ä forstÄ hva Open Source er bÞr vi gÄ (minst) 40 Är tilbake i tid. Opprinnelig var programvare noe ganske smÄtt som fulgte med maskinvare, men utover 70-tallet ble det stadig vanligere, med Bill Gates i spissen, Ä holde kildekoden man skrev hemmelig og selge programvaren separat, for Ä gjÞre det vanskeligere Ä konkurrere. Det var den fÞrste vollgraven.

En utvikler og filosof ved navn Richard Stallman sĂ„ til Kants etikk og skrev at Ă„ sette restriksjoner pĂ„ menneskers bruk av et program reduserer verdien menneskeheten kan hente ut av programmet, noe som vil gjĂžre oss alle fattigere. Som en fĂžlge av dette begynte han Ă„ utvikle de helt fundamentale komponentene av IT-systemer og formulerte fire friheter: Friheten til Ă„ kjĂžre programmet som du vil, friheten til Ă„ studere programmet og gjĂžre endringer, friheten til Ă„ spre kopier for Ă„ hjelpe andre, og friheten til Ă„ spre dinne endringer til Ă„ andre. Han kalte dette “Free Software”, oversatt til “fri programvare”.

Selv om Stallman i dag kan karakteriseres som en lĂžs kanon pĂ„ dekk, og koden ikke har overlevd sĂ„ mener jeg at dette arbeidet var av fundamental viktighet, og det etablerte ogsĂ„ en annen viktig ting: Slik programvare er en allmenning, spesifikt passer det i nobelprisvinner Elinor Ostroms klassifikasjon i hennes arbeid om komplekse Ăžkonomiske systemer som en “Public Good”, altsĂ„ det er ikke et eksklusiv gode og mitt bruk Ăždelegger ikke for ditt bruk.

PĂ„ slutten av 90-tallet hadde fri programvare fĂ„tt stor spredning og utviklet seg i tandem med Internet. Internet ble utviklet i Ă„pne fora med fĂ„ eller ingen restriksjoner, og for det meste implementert med fri programvare. Det har alltid vĂŠrt store spenninger rundt konseptet, og i 1998 samlet en del mennesker seg i Silicon Valley og fant ut at den kantiske etikken stod i veien for videre spredning og Ăžnsket Ă„ bruke begrepet “Open Source” fordi de mente at konseptet stod seg vel sĂ„ godt pĂ„ sine egne business-ben. Det slo an, selv om flere av de sentrale personene raskt forsto at etikken var viktig likevel.

Free Software leder tankene til gratis, og ettersom programvaren ikke er eksklusiv kan den gjerne fĂ„s gratis. Det Ăžkonomiske insentivet er langt mindre og det er problematisk, men det er mest fordi samfunnet tenker pĂ„ programvare som et produkt og ikke som noe som skal lĂžse et problem. Det ble raskt gjort et forsĂžk pĂ„ Ă„ skille “free as in speech” fra “free as in beer”, med den forstĂ„elsen at det man Ăžnsker Ă„ oppnĂ„ er frihet, som i ytringsfrihet, mens gratis ikke engang er et ideal. Tvert i mot, fĂ„r du gratis Ăžl ligger det nok en baktanke bak, og dine evner til Ă„ se det blir sannsynligvis svekket av gratis Ăžl.

Det er kanskje ikke sÄ lett Ä fÄ Þye pÄ, men i dag er slik programvare over alt. Den gjÞr at mobilen din kjÞrer, at datasentre fungerer og alt i mellom. Selv nesten alle lukkede systemer inneholder Open Source. Det er i samarbeid de virkelig store verdiene oppstÄr, og dette gjÞr Open Source sÄ kraftig. Dette er ikke et eksotisk innslag, men likevel diskuteres det nesten aldri.

Altfor mye gratis Ăžl

Dessverre har det blitt altfor mye gratis Þl, bÄde i Äpne og lukkede systemer. NÄr notatet til personen i Google foreslÄr Ä dominere Open Source, sÄ er det en gratis Þl-strategi som foreslÄs.

Vi har klart Ă„ skape mye programvare, og Internet-standarder har ofte hatt ganske gode og Ă„pne prosesser med mange deltakere. Dessverre gĂ„r det en grense. En komponent startes ofte av en enkeltperson. NĂ„r det blir nyttig for flere, tiltrekker det seg flere bidragsytere, og ofte blir grunnleggeren da en BDFL — “Benevolent Dictator for Life”. Det er Ă„penbart et fleipete begrep, men brukes likefullt. Ettersom prosjektene vokser har de ofte gĂ„tt over til Ă„ bli et stĂžrre meritokrati. De siste Ă„r har store teknologiselskaper startet prosjekter og styrt meritokratiet.

Problemet er nÄr programvare blir fundamental infrastruktur for samfunnet: Det vi aldri har klart er overgangen fra meritokrati til demokrati.

Det er da viktig Ä forstÄ at lukket og eksklusiv programvare i sin natur er vanskelig regulerbart, det ligger i forretningsstrategiens natur at kunnskapen om hvordan systemet faktisk fungerer mÄ ligge i selskapet, fordi det er ikke selve programvaren som er konkurransefortrinnet, det er kunnskapen bak. Selve programvaren er enkel Ä skrive pÄ nytt hvis man har kunnskapen. Denne ubalansen er en viktig Ärsak til at teknologien lar seg styre sÄ dÄrlig.

Det er paradoksalt, dette er fullstendig menneskapte ting og burde vÊrt lett Ä styre, men vÄr samarbeidsevne er sÄ dÄrlig at vi mislykkes.

Jeg har vĂŠrt meritokrat

Jeg har selv vĂŠrt meritokrat, og vet veldig godt hvordan det er Ă„ utfordre det paradigmet. Jeg ble fĂžrste ansatte i et selskap ved navn Inrupt. Selskapet ble feiret med store presseoppslag og “Boldness in Business” i Financial Times, en artikkel som beskriver godt hva vi trodde pĂ„. Det fĂžrste halvannet Ă„ret var fantastisk inspirerende. Men sĂ„ kom det inn et lag med mellomledere som hadde helt andre ideer. Det ble bestemt at en lukket server skulle vĂŠre hovedproduktet. Den vanligste arkitekturen pĂ„ nett er kjent som klient-server-arkitektur, og i en slik arkitektur sitter nesten all normativ makt pĂ„ server-siden, hvilket betyr at den som skriver serveren, hvis det er bare en, sitter med makten.

For Ä unngÄ slik maktkonsentrasjon sÄ skriver man gjerne en presis spesifikasjon, noe som ble min jobb sammen med Sarven Capadisli og Tim Berners-Lee. Sistnevnte fant opp webben, er selskapets teknologidirektÞr og noe av en BDFL for prosjektet. Da kan makten forskyves til gruppa som bestemmer hva som skal stÄ i spesifikasjonen. Jeg prÞvde mitt beste for Ä sikre en bredest mulig forankring av dette arbeidet. Jeg prÞvde alt jeg kunne Ä gÄ fra meritokrati til demokrati. Det var tross alt demokrati vi solgte.

SelvfÞlgelig feilet jeg. Demokrati bygger ingen vollgrav. Selskapet skulle selge en server og hvis jeg lyktes med min jobb ville framtidige konkurrenter lett konkurrere den ut. Dermed sÞrget mine sjefer for Ä ta alle prosesser inn bak lukkede dÞrer og ikke delta i noen offentlige prosesser de ikke fullt kontrollerte, samtidig som de snakket varmt om Äpenhet offentlig.

Vi har et begrep for det: Commonswashing. Det har blitt viktig for teknologiselskapene Ä virke Äpne men i praksis har lite endret seg.

Det vi mangler

Vi mangler ikke forskning, duppeditter eller tenketanker. Vi mangler institusjoner som kan bidra inn i Þkosystemer og sikre overgangen fra meritokrati til demokrati. Mesteparten av programvaren har vi allerede, men vi mÄ spisse oss inn pÄ de konkrete tilfellene der industrien henter makt.

Det betyr at vi mÄ forstÄ nÄr teknologien setter normer i samfunnet. Langt fra all teknologi gjÞr dette, og der vil jeg vÊre langt mer pragmatisk enn Richard Stallman var. Men nÄr den gjÞr det, mÄ vi sikre at ingen kan utÞve eksklusiv kontroll, fordi da er det ikke demokratiet som setter normene. Og det er her Open Source kan hjelpe, fordi hverken Google eller OpenAI har vollgrav mot det.

En vond erfaring rikere har jeg nÄ en ganske god ide om hvordan vi kan sÞrge for at de ikke fÄr bygget denne vollgraven.

Det er mange andre som ogsĂ„ tenker samme tanker, men de fleste har gĂ„tt pĂ„ en smell. EU-kommisjonen og delstatsregjeringen i Flandern er blant dem som ikke forsto taktikken til min tidligere arbeidsgiver. Europa prĂžver Ă„ etablere digital infrastruktur, og Frankrike snakker om “Digital Sovereignty”. Det er absolutt prisverdig, men i sluttfasen av forhandlingene om AI Act lĂŠrte de pĂ„ den harde mĂ„ten at Mistral AI ikke hadde spilt med sĂ„ Ă„pne kort som de lot som. Uten ordentlige institusjoner vil vi komme til kort gang pĂ„ gang.

Drittifiseringsprosessen er i full gang

Hvordan vil det gĂ„ hvis det fortsetter slik det er nĂ„? Kommentatoren Cory Doctorow har etablert begrepet “enshittification”. BjĂžrn StĂŠrk oversatte det til “drittifisering” i en kronikk i Aftenposten.

Hvordan kan en drittifiseringsprosess se ut pÄ KI-omrÄdet? Jeg mener vi allerede er i fÞrste fase: Selskapene bygger ganske imponerende tjenester man kan fÄ tilgang til for en billig penge eller gratis. Men som gratis Þl er det en felle, det er for Ä fÄ deg innenfor vollgraven. Dette skjer i form av at de bygger infrastruktur som kundene virkelig trenger og som de nÄ bindes til, kostnadene for Ä skifte mÄ opp. Open Source er forelÞpig eneste middel mot dette. Hvem, i den panikken vi nÄ ser der Digitaliseringsministeren sier at 80% av offentlig sektor skal hoppe pÄ bÞlgen raskest mulig, vil faktisk ha mot og distanse nok til Ä se at de blir lurt?

Den andre delen nÄ er Ä etablere et narrativ om at KI er ekstremt kapitalkrevende, og at det derfor ikke gir mening Ä bÊre disse kostnadene selv. Om narrativet er sant eller ikke er jeg usikker pÄ, men jeg er sikker pÄ at det ikke kommer til Ä vÊre sant sÄ veldig lenge. Men det spiller ingen rolle, fordi investorene tar kostnaden med kalkulert risiko om at drittifiseringen vil lykkes. Det er i denne konteksten Sam Altman mÄ forstÄs.

For dem er det eneste viktige nĂ„ at vollgraven er ferdig fĂžr skruen mĂ„ vris om eller “compute” har blitt for billig.

Neste steg i drittifiseringsprosessen tipper jeg er Ä utnytte nettverkseffektene som oppstÄr nÄr man har data fra mange aktÞrer. Da kan man trekke slutninger de som har mindre data ikke kan trekke, og disse vil ha stor verdi. Da kommer festningsmurene opp ogsÄ, og dermed er du virkelig fanget. Vi blir fanget alle sammen fordi det er vÄre data som kommer til Ä gÄ inn den store kverna vi ikke har kontroll pÄ.

I en slik verden er verdi-basert innovasjon umulig, fordi du vil alltid vÊre begrenset av en sterkere infrastruktur-eier. Det er infrastruktur-eieren som henter ut belÞnningen av ditt arbeid og som bestemmer rammene for hva du fÄr lov til Ä gjÞre. Slik er verden allerede nÄ pÄ veldig mange omrÄder, og slik vil den ogsÄ om fÄ Är vÊre pÄ KI-feltet hvis vi ikke klarer Ä etablere en annen styring av teknologi enn det vi har i dag.

Hvert enkelt selskap stÄr ikke sÄ stÞtt, men noen av dem vil nok lykkes med drittifisering, da det er lite som kan stanse den prosessen.

Det er mange dyktige teknologer i dag som ser stor framtid for teknologien og de mange gode anvendelser. Jeg har vÊrt som dem, men jeg er ikke det i dag. Langs veien vi gÄr i dag er det ikke anvendelser som avgjÞr om dette kommer til Ä gÄ bra for menneskeheten.

Vi mÄ gÄ en annen vei, med tverrfaglige institusjoner som utvikler teknologi med et demokratisk mandat i store, Äpne Þkosystemer. Da fÄr vi kunnskapen vi trenger til Ä skape normer, vÄre bedrifter kan innovere og med tiden vil nok de store teknologiselskapene innordne seg med denne realiteten, de har tross alt allerede store bidrag inn i Open Source.

Fra vondt til verre i Hakkebakkeskogen

Skal vi tro Bakermester Harepus har det mye Ä si hvem som spiser kakene, kaker som er stjÄlet smaker surt, kaker som er kjÞpt, smaker sÞtt. SÄnn er det med teknologi ogsÄ: Teknologi som innfÞres i et ondt system blir ond, teknologi som innfÞres i et godt system kan bli god. For Ä gjÞre systemet godt mÄ nye samfunnsinstitusjoner til.

Å innfĂžre en aldersgrense pĂ„ sosiale medier med ny teknologi for Ă„ verifisere alder i dagens situasjon er bare en runde til med “technosolutionism”. Det vil ikke fĂžre noe godt med seg. Men jeg sier det ikke fordi jeg ikke tror det er sĂ„ farlig med sosiale medier, tvert i mot, disse sosiale mediene vi har i dag har vĂŠrt en katastrofe for menneskeheten sett i forhold til hvordan sosiale medier kunne ha vĂŠrt. For meg var ikke Facebook starten pĂ„ sosiale medier, det var slutten. Det var da alle kamper var tapt, og dette tapet skjedde i 2005. De siste nesten 20 Ă„r har vĂŠrt en lidelse der det hele tiden har overrasket meg at ingen andre har sett det, fĂžr nĂ„ plutselig.

Reven av i dag er, i motsetning til Mikkel i Hakkebakkeskogen, ganske smart men bare for sin egen mages skyld. Ugla har en dronesverm som overvĂ„ker hver flik av skogen til enhver tid og pinnsvinet er blitt CEO i “Hyper Hedgehog & Bro Inc”. De stakkars musene kan definitivt ikke gĂ„ ut av huset sitt uten Ă„ bli spist. Dermed kommer de seg heller ikke til Bamsefar med forslag til hva man kan gjĂžre.

SÄ hva gjÞr myndighetene i Hakkebakkeskogen? Jo, unge mus er lovpÄlagt Ä holde seg hjemme. Paraplyer er forbudt fordi hvis Bestemor Skogmus bruker det kan ingen vÊre sikker pÄ om de angriper en mus eller andre. Det skulle tatt seg ut om noen spiste Ekorn-Jensen for eksempel.

Sikker identifikasjon blir viktig, og derfor investerer myndighetene i teknologi som Hyper Hedgehog & Bro industrialiserer, slik at rever og ugler kan vÊre sikker pÄ Ä ikke angripe et dyr man ikke mente Ä spise.

Si meg: Er det ingen som ser det gale i at staten bruker tvang mot offeret og ikke mot dem som prĂžver Ă„ spise dem?

NĂ„r aldersgrensen skal hĂ„ndheves er det sannsynlig at man vil bruke European digital identity som EU foreslĂ„r. Gjennom mitt arbeid med Solid-protokollen har jeg fulgt arbeidet med den underliggende teknologien i mange Ă„r. Ikke bare gir den en identitet, men ogsĂ„ en “wallet”, en lommebok, som holder dine viktigste data. Jeg mĂ„ tilstĂ„ at jeg ogsĂ„ har trodd at Ă„ innfĂžre slik identitetsteknologi vil sette i gang en revolusjon som vil gi borgerne stĂžrre innflytelse over eget liv. Det tror jeg ikke lenger.

I en skog der alle dyrene er venner kunne dataene i lommeboka styrket individets rettigheter. Men dyrene er ikke venner, og det gjÞr at nÄr fÞrst lommeboka eksisterer, sÄ vil Hyper Hedgehog & Bro utnytte situasjonen. Det er en smal sak Ä overtale musene til Ä dele data fra lommeboka om hvem som er sterk og svak slik at de kan fÄ et fint treningsopplegg. Det er ikke det at teknologi kan misbrukes, i dagens samfunn vil den helt sikkert misbrukes.

Dermed kan data om hvilke mus som er svakest selges til hÞystbydende, og alle er skjÞnt enige om at det er de svakeste som bÞr spises fÞrst. Det er bra for Þkosystemet. Ugla bidrar med data fra dronene, et samarbeid gir merverdi og dermed blir dette det mest feirede innovasjonsprosjektet i skogen. Et glimrende eksempel pÄ hvordan regulering gÄr hÄnd i hÄnd med industriens behov.

Men vent nÄ litt! Har vi glemt at mÄlet var en god skog Ä bo i for alle? At musene mÄ fÄ komme ut og at reven kanskje hadde rett i at grÞnnsaker og nÞtter ikke var noe for en hel rev?

Politikerne gjĂžr mange antagelser om teknologi som det ikke er hold i. De antar vel at sosiale medier er vanskelig Ă„ utvikle, siden det er milliardkonsern som gjĂžr det? Men husk at det er ikke sosiale medier som er produktet, det er den enkle biten. Produktet er en overtalelsesplattform. For mĂ„lrettet reklame. Sosiale medier bestĂ„r av bare tre hovedkomponenter: en identitet og noe som hĂ„ndterer brukernes data, og et forslagssystem (“recommender system”). De to fĂžrste har vi allerede, og forslagssystemet er det lekfolk snakker om som “Algoritmen”. Siden forslagssystemer kan styre det offentlige ordskiftet mĂ„ staten ta ansvar i fĂžlge Grunnlovens §100.

At man ikke oppfyller ansvaret ved bare Ä skrive lover bÞr vÊre tydelig nÄ. GDPR har ikke hatt nevneverdig effekt etter 6 Är, og alt som kommer etter er skrevet pÄ samme lest.

En klok liten mus vet at sosiale medier kan bli noe helt annet enn det vi har i dag. Vi kan dyrke de positive sidene ved det, for vi vet at de finnes. Men i dag blir mange stemmer aldri hĂžrt!

Vi piper om at det finnes sÄ mye programvare allerede som ikke er eid av Hyper Hedgehog & Bro og andre Incs, at vi allerede har sÄ mye som tilhÞrer felleskapet at vi kan oppnÄ maktbalanse ved Ä opprette nye samfunnsinstitusjoner. Hvordan de kan se ut fÄr du vite hvis musene fÄr snakke!

Slik jeg opplevde historien

Jeg mÄ fÄ lov til Ä vÊre hovedpersonen pÄ min egen blogg. Jeg vil gjerne fÄ fortelle historien om hvorfor jeg ikke tror at dagens politiske virkemidler vil klare Ä gi oss bedre teknologi. Ja, fordi jeg ser jo det slik at sosiale medier kunne blitt en fantastisk ting for menneskeheten, men at sentralisering av makt i noen fÄ selskap Þdela det. Og dette skjedde ikke nÄ nylig, Facebook var ikke begynnelsen av sosiale medier, det var slutten. Facebook var det som stod igjen nÄr alle kamper var tapt. Dagens AI er heller ikke pÄ noen mÄte fundamentalt nytt og oppstÄr ikke som en egen retning, den er et resultat av alt som har gÄtt galt, lagd av folkene som Þdela alt. Det kommer ikke til Ä gÄ godt.

La meg ta dere tilbake til en lystigere tid, en tid der framtiden sĂ„ virkelig mye lysere ut, ihvertfall for mine unge Ăžyne. Jeg fikk en konto pĂ„ Internett av Universitetet i Oslo i 1994. Nettleserne har et valg der man kan gjĂžre “View Source”, som gjĂžr at man kan se hvordan nettsiden er bygd opp og opplevelsen av at man kunne se hvordan folk lagde ting og forstĂ„ det, ja, jeg forsto det, jeg kunne bygge min egne ting. Jeg kunne dele med verden, og vi kunne dele med hverandre.

Jeg sÄ ogsÄ raskt at standardene ble utviklet i Äpne miljÞer. Man kunne skrive seg pÄ en e-post-liste og dele ideer, diskutere andres ideer og fÄ forstÄelse for hvordan man utvikler standarder. Jeg var med pÄ en rekke slike. Det var en tid da teknologiutvikling foregikk Äpent med mulighet for Ä delta.

Det var ikke det at de ikke fantes en tydelig mĂžrk side. En av disse mĂžrke sidene kastet jeg meg hodestups inn i da jeg startet hjemmesidene til foreningen Skepsis i 1996. Jeg var ogsĂ„ i diverse nettfora der folk snakket om de merkeligste ting. Selv om jeg syntes de hadde veldig rare ideer var det likevel lett Ă„ forstĂ„ at de var mennesker, de ogsĂ„. Kanskje derfor ble den mĂžrke siden enda mĂžrkere siden jeg sĂ„ den sentralisering av makt som var i ferd med Ă„ skje. Richard Stallman sitt essay “Right to Read” fra 1997 fanger denne tidsĂ„nden godt. Selv om det ikke er sĂ„ velskrevet science fiction, er det egentlig skummelt realistisk.

Men den som traff aller best nĂ„r det gjaldt Ă„ forutsi framtiden var kanskje den berĂžmte astronomen Carl Sagan. I sin bok “A Demon-Haunted World” skrev han i 1995:

I have a foreboding of an America in my children’s or grandchildren’s time — when the United States is a service and information economy; when nearly all the key manufacturing industries have slipped away to other countries; when awesome technological powers are in the hands of a very few, and no one representing the public interest can even grasp the issues; when the people have lost the ability to set their own agendas or knowledgeably question those in authority; when, clutching our crystals and nervously consulting our horoscopes, our critical faculties in decline, unable to distinguish between what feels good and what’s true, we slide, almost without noticing, back into superstition and darkness. The dumbing down of America is most evident in the slow decay of substantive content in the enormously influential media, the 30 second sound bites (now down to 10 seconds or less), lowest common denominator programming, credulous presentations on pseudoscience and superstition, but especially a kind of celebration of ignorance. As I write, the number one video cassette rental in America is the movie Dumb and Dumber. Beavis and Butthead remains popular and influential) with young TV viewers. The plain lesson is that study and learning — not just of science, but of anything — are avoidable, even undesirable.

We’ve arranged a global civilization in which most crucial elements — transportation, communications, and all other industries; agriculture, medicine, education, entertainment, protecting the environment; and even the key democratic institution of voting — profoundly depend on science and technology. We have also arranged things so that almost no one understands science and technology. This is a prescription for disaster. We might get away with it for a while, but sooner or later this combustible mixture of ignorance and power is going to blow up in our faces.

Det var en slik forstĂ„else av verden som gjorde at jeg begynte med Skepsis i utgangspunktet. Det er viktig da Ă„ forstĂ„ at massemediene var skikkelig dĂ„rlige. De har blitt langt bedre nĂ„, men da var de svĂŠrt uetterrettelige nĂ„r det kom til naturvitenskap. I denne perioden opprettet ogsĂ„ professor i kjemi Martin Ystenes ved NTNU sin “SprĂžytvarsler”-blogg.

“Men pĂ„ Internett er det ikke dem, det er bare et veldig stort oss“, skrev den svĂŠrt gode science fiction-forfatteren Douglas Adams i 1999 (Mest kjent for “Hikerens guide til galaksen”). Å, jeg elsket det essayet. Jeg gjĂžr det egentlig fortsatt, fordi jeg sĂ„ veldig unner barna mine Ă„ fĂ„ leve i en verden sĂ„ naiv som det Douglas Adams beskrev. Ikke fordi den var slik da, men fordi verden burde gĂ„ framover slik at den blir slik.

Essayet peker pÄ de mange moralpanikkene som drev debattene. Det peker pÄ at det viktigste vi vant var interaktivitet. Vi kunne publisere, vi kunne mÞte andre mennesker, vi kunne forstÄ dem og de kunne forstÄ oss. Vi kunne bygge ting som veldig mange mennesker kunne ha nytte av. Essayet pÄpeker at teknologien allerede var sosial, der mobiler ble vanlige, ble SMS en viktig mÄte Ä vÊre sosial pÄ. For oss som opplevde dette var det sÄ uendelig verdifullt, det var en mÄte Ä vÊre sosial pÄ som styrket menneskelige bÄnd. Jeg hadde venner i bryllupet mitt jeg hadde mÞtt pÄ IRC. Vi har fortsatt kontakt.

I disse sosiale mediene kunne jeg mÞte noen som mente jeg var med pÄ en konspirasjon for Ä ta over verden. Det at jeg mente at vi ikke hadde romvesener rundt oss var uttrykk for at jeg var med pÄ denne konspirasjonen, sa dem. Men jeg kunne prate med dem og etablere en felles forstÄelse. Jeg klarte kanskje ikke Ä overbevise dem om at en konspirasjon ikke fantes, men jeg kunne overbevise dem om Ä at den ondskapen de sÄ ikke fantes, og jeg kunne forstÄ at det fantes en vond bakgrunn for deres tro.

Det gikk ikke like bra overalt. En del av nettet som kom fÞr Webben het USENET, som var delt opp i titusenvis av tematiske grupper. En av disse gruppene var alt.fan.pooh, som var dedikert til fans av Ole Brumm. Man skulle tro at Brumm-fans var de fredeligste av alle mennesker pÄ planeten, men denne gruppa brÞt stadig ut i kriger over om Disney-brumm var ekte saker. Jeg er ikke i tvil om at mediet har mye Ä si for hvor godt dialogen fungerer og USENET var ikke spesielt godt egnet. Men min andre erfaring var at det er mulig Ä skape broer.

Men da mÄtte vi ha en kritisk debatt som var bÄde effektiv, brobyggende og opplysende. Erfaringen fra 1997 ble at problemet ikke var Ä fÄ informasjon ut, det var ikke fakta som betydde all verden. Det handlet om Ä fÄ kunnskap inn i lukkede sinn. Og dermed mÄtte man forstÄ hvorfor de var lukket, men det var en problemstilling som ble for vanskelig. Jeg begynte derfor Ä tenke pÄ en lÞsning der vi kategoriserte artikler i forskjellige omrÄder og der vi kunne tydeliggjÞre hva som var kritikk eller stÞtte til hva. Tanken var at nettleserne kunne komme med en liten linje som fortalte at de du sÄ pÄ var kritisert av en artikkel pÄ et helt annet sted pÄ nettet, eller at sÞkemotorene kunne gjÞre det samme. Jeg satte opp en e-post-liste der en lÞs gruppe drodlet litt rundt disse ideene. Men fÞrst mÄtte jeg gjÞre ferdig mitt hovedfag i teoretisk astrofysikk. Jeg fikk litt penger til det av Skepsis, og i mellomtiden hadde andre ogsÄ fÄtt liknende ideer. Vel, man kan vel si at det var overambisiÞst og langt foran infrastrukturen som kunne ha hjulpet det opp. Vi er nÄ i 2002-2003.

Internett vokste gjennom denne perioden, og det betyr at det var tross alt fÄ som var pÄ nett i perioden og totalt sett fÄ som fikk oppleve det jeg gjorde. Dessverre tror mange at Facebook var starten pÄ sosiale medier. Det preget ogsÄ forskningen, man etablerte omtrent ingen akademisk forstÄelse for det jeg opplevde, og fÞrst i 2005, altsÄ Äret etter at Facebook kom, etablerte ForskningsrÄdet VERDIKT-programmet der sosiale nettverk var et av tre hovedtema. Forskningen kom altsÄ ikke i gang fÞr alle kamper var tapt, den kom nÄr den virkelige interaktiviteten vi hadde ble redusert til posering og brubyggingen var avsluttet, og sentralisering av makt i noen fÄ selskaper var etablert.

Likevel hadde jeg troen pÄ kraften i sosiale medier. Jeg jobbet et par Är pÄ My Opera Community, som var Opera Software sitt forsÞk pÄ Ä lage sosiale medier. Jeg prÞvde Ä overtale ledelsen til Ä la det fÄ ta en annen retning: I stedet for et sentralisert sosialt medium, skill dataene fra applikasjonen slik at hvem som helst kan bygge sin del, og sÄ kan vi heller prÞve Ä gi den beste brukeropplevelsen til dette. Jeg hadde ikke tro pÄ at vi ville kunne konkurrere nÄr det var kjemper pÄ vei opp med enorme mengder penger, som MySpace pÄ den tiden. Jeg fikk oss invitert inn i et stort forskningskonsortium for Ä jobbe med dette, men ledelsen var ikke interessert.

Det er ikke lett Ä gi opp en ide som har satt sÄ dype spor i en. Det var ikke fÞr i 2007 at jeg virkelig ga opp troen pÄ at datidens sosiale medier kunne endres til Ä bli noe bra.

Men la oss gÄ tilbake til Douglas Adams sitt essay. For meg som var 21 Är gammel da jeg fÞrst lagde en hjemmeside var det lett Ä glise gjenkjennende til hans tre regler for hvordan man forholder seg til oppfinnelser:

  1. alt som finnes i verden da du blir fĂždt er bare normalt;
  2. alt som blir funnet opp mellom da og fĂžr du fyller 30 er veldig spennende og kreativt og med litt flaks kan du lage en karriere av det;
  3. alt som blir funnet opp etter at du blir 30 er mot naturens orden og begynnelse pÄ slutten av siviliasjonen som vi kjenner den, til det har vÊrt der i rundt ti Är, da det begynner Ä bli greit likevel.

NÄr jeg hÞrer folk (som digitaliseringsministeren) snakke om AI i dag, sÄ ser jeg den entusiasmen som ligger i punkt 2. Jeg ser at den entusiasmen jeg fÞlte for Webben og de tidlige sosiale nettverk. SÄ er det bare det at jeg nÄ har havnet i punkt 3 pÄ grunn av alderen?

Dagens sosiale medier har vÊrt her i 20 Är, og har ikke blitt greit. La meg fortelle om Hossein Derakhshan. Derakhshan kommer fra Iran og startet en bevegelse med blogging. Han fikk i gang en samfunnsdebatt som landet sÄ sÄrt trengte og som det ikke var plass til noen andre steder. Han bodde i Kanada, men flyttet tilbake til Iran for Ä vÊre nÊr folkene han brydde seg om og skrev om. I 2008 ble han arrestert og dÞmt til nesten 20 Är fengsel. Han ble frigitt i 2014. PÄ siden av historien med undertrykkingen i Iran skrev han om hvordan Webben endret seg pÄ de 6 Ärene han satt inne. Som han noterte, skrollingen vi driver med i dag er ikke virkelig sosial. Vi har mistet mye av den virkelige interaktiviteten vi hadde med den tidlige Webben.

Det skjedde nesten umerkelig for det fleste av oss, men det var akkurat det som gjorde meg sÄ lei meg da jeg til slutt ga opp. FÞrst nÄ begynner samfunnet Ä se det, men fordi sÄ fÄ har opplevd hvordan en sosial Web virkelig kan vÊre, sÄ er det en generell backlash for sosiale medier og ikke et forsÞk pÄ et etablere noe bra.

Vi har mistet den verdien som Douglas Adams sÄ i 1999, og derfor tror jeg at han ville vÊrt enig med meg i at det er ikke bare meg som har blitt gammel. Det er faktisk slik at dette har vÊrt med oss i 20 Är og har blitt noe helt annet enn greit. Tiktok er sÄ dÄrlig at barna min skulle Þnske at det ikke eksisterte selv om noen av dem bruker det hver dag.

En som ogsĂ„ viste at det kunne bli bra er den berĂžmte psykologen Martin Seligman. I boka Flourish skriver han om et mĂžte med store teknologiselskap i 2010, deriblant Facebook. Han skriver at han sa (lett omskrevet): “slik det stĂ„r nĂ„ sĂ„ kan Facebook faktisk vĂŠre i gang med Ă„ bygge fire av elementene i well-being: positive fĂžlelser, engasjement, positive relasjoner og prestasjon. Det femte elementet mĂ„ dere jobbe med, i det narsissistiske miljĂžet pĂ„ Facebook haster det Ă„ bygge noe for Ă„ kjenne at man er med pĂ„ noe stĂžrre enn seg selv, finne en mening”. Facebook valgte Ă„ gjĂžre det motsatte, selvfĂžlgelig.

Sosiale medier kunne blitt noe som er virkelig bra for menneskers well-being, det kunne bygd bruer for Ä dempe konflikt, det kunne forbedret offentlig debatt, det kunne bidratt til Ä dempe informasjonsforurensing, det kunne ha fÞrt mennesker nÊrere hverandre, bÄde ved Ä gjÞre at vi kommer fysisk sammen der det er mulig og virtuelt der det blir for vanskelig.

Joda, til en viss grad har det ogsÄ gjort det, men til en mye mindre grad enn det kunne. Vi har hele veien gjort valg som har fÞrt oss kollektivt inn i denne krisesituasjonen vi er i nÄ. Det er kun menneskeskapte ting her, dette er resultat av aktive valg, ikke naturlover.

Det skjedde noe spennende i 2009, da Elinor Ostrom fikk “Nobelprisen” i Ăžkonomi. Jeg skal innrĂžmme at min fĂžrstereaksjon var at utvikling av “commons” eller allmenninger pĂ„ norsk var noe programvaremiljĂžet hadde drevet med i Ă„rtier, ja, det er jo dette som ligger bak “Open Source”, som i dag omfatter det aller meste av programvare. Men der holdt jeg pĂ„ Ă„ miste et stort poeng. Mennesker har holdt pĂ„ med dette i tusener av Ă„r, og har blitt skikkelig gode pĂ„ det. Det har kommet pĂ„ moten Ă„ snakke om “tragedy of the commons”, at alle bare er egoistiske aktĂžrer som Ăždelegger for felleskapet, men Ostrom viste at det er unntaket, at hovedregelen er at mennesker er flinke til Ă„ organisere seg rundt allmenninger. Det Ă„ skrive “open source” eller fri programvare er noe jeg har drevet med i siden 1995.

Egentlig tok jeg et skritt vekk i 2010 da jeg begynte pĂ„ en ph.d. i informatikk ved Universitetet i Oslo. Jeg kjente pĂ„ at det ikke var sĂ„ mye mer IT-industrien som jeg da egentlig hadde jobbet i 8 Ă„r, kunne gjĂžre. Men ogsĂ„ her var den enkleste veien Ă„ gĂ„ en vei mot sentralisering av makt. La meg ta dere tilbake til en akademisk konferanse i 2012, der en ledende forskergruppe presenterte “Learning from the History of Distributed Query Processing: A Heretic View on Linked Data Management”. Bakgrunnen er at en del akademikere, meg seg inkludert, hadde argumentert for at mange ting ville bli enklere om man ikke sentraliserte data, men holdt det under kontroll av organisasjonene som uansett var nĂŠrmest dataene. Dette var det dominere synet, sĂ„pass sterkt at de fĂžlte for Ă„ kalle arbeidet sitt kjettersk. Jeg har alltid likt en god kjetter, og det gjorde visst resten av publikum ogsĂ„, kommentarene i ettertid var stort sett for Ă„ takke forfatterne for Ă„ endelig ha sagt det mange hadde tenkt.

Men min motivasjon var helt anderledes: De sosioteknologiske fÞlgende av sentralisering, for demokrati, for skaperevne og for menneskers frihet er sÄ store og alvorlige at vi mÄ fÄ til desentralisering pÄ tross av at det er teknologisk vanskeligere pÄ alle mulige mÄter. Da jeg senere mÞtte lederen for denne forskergruppen under et Dagstuhl-seminar klarte jeg Ä overbevise ham om at dette gjÞr det til et viktig mÄl for forskning. Min ph.d. er derfor motivert ut fra sosiale, og ikke teknologiske mÄl.

Blant disse mĂ„l er ogsĂ„ Ă„ sĂžrge for at man ikke skal mĂ„tte oppgi mer data om seg selv enn strengt tatt nĂždvendig. ForlĂžperteknologien relasjonsdatabaser (som fortsatt er svĂŠrt vanlig) bestĂ„r av tabeller og databasene liker ikke at det er felter i tabellen uten noe i. Teknologien jeg jobbet med tar et oppgjĂžr med dette og legger til rette for at man like greit skal jobbe med data med hull. I personvernforordningen GDPR prĂžvde EU Ă„ legge inn et prinsipp om “dataminimering”. Dataminimering fĂžrer til at man kommer til Ă„ fĂ„ hull i dataene, men har blitt et av de mest ignorerte prinsippene i GDPR, ikke minst fordi maskinlĂŠringsfolkene ikke liker “hull i tensorene”. De problematiserer voldsomt rundt det og pĂ„stĂ„r gjerne at “teknologer ikke liker dataminimering” og at det er “bare sĂ„nn teknologien er”. Ikke hĂžr pĂ„ dem, de som sier sĂ„nt forsvarer bare et teknologisk hegemoni som er skapt av nĂžyaktig dem som Ăždela sosiale medier.

Men la meg bli litt lystigere en kort stund: Min karriere tok en veldig spennende vending da jeg fikk vite om at “noen folk i Boston” drev med en startup rundt Solid, et prosjekt jeg allerede kjente ganske godt, faktisk var mye av det jeg gjorde helt fra da jeg oppdaget RDF relevant. Jeg ble fĂžrste ansatte i Inrupt i juni 2018, og folkene bak var blant andre Tim Berners-Lee, som er kjent som han som fant opp Webben. Jeg hadde mĂžtt ham flere ganger i Ă„rene fĂžr ogsĂ„. Det fĂžrste halvannet Ă„ret var Inrupt det mest stimulerende miljĂžet jeg har vĂŠrt i i min karriere. Tim ble utropt til “Boldness in Business person of the year” av Financial Times, en artikkel som beskriver veldig godt hva vi trodde pĂ„. Min jobb beskrives der ogsĂ„, “Ă„ skrive ned ting pĂ„ en veldig tydelig mĂ„te”. Jeg er fortsatt litt involvert i noen av disse dokumentene, det mest sentrale er protokollen som ligger under hele teknologien. Vi var tilbake til den tiden der alt kunne gjĂžres i offentligheten og folk kunne involvere seg, men med 20 Ă„rs erfaring og ph.d. i feltet satt jeg nĂ„ pĂ„ toppen av det hele. Det var en litt rar opplevelse. Medier og politikere er ekstremt opptatt av celebritet, det er bare celebriteter som blir spurt om Ă„ uttale seg, og som faktisk kan pĂ„virke politikken. Med dette fikk jeg ogsĂ„ litt av celebritetens lys pĂ„ meg. Det resulterte blant annet i et intervju i Dagsavisen. Det er spesielt Ă„ se tilbake pĂ„ nĂ„, fordi jeg trodde pĂ„ det jeg sa. Jeg hadde internalisert selskapets budskap. Jeg trodde virkelig at hvis vi ga folk tilbake kontrollen over egne data ville en revolusjon fĂžlge.

Det tror jeg ikke lenger. Jeg tror ikke pÄ noen enkelttiltak lenger, det er ytterst komplekst, men det jeg er helt sikker pÄ er at vi mangler samfunnsinstitusjoner for Ä takle det.

Det kom inn et lag med mellomledere i selskapet, og de hadde helt andre ideer om Äpenhet. For dem var det kun et skalkeskjul for Ä sette agenda selv og styre teknologiutviklingen helt og holdent pÄ selskapets premisser. De diskusjonene som vi hadde hatt Äpent ble flyttet inn bak lukkede dÞrer. Det var ingenting nytt og ingen virkelig innovasjon i dette, det handlet bare om makt. Bisart nok ble forretningsmodellen Ä selge en server, mens min jobb, Ä skrive klart og tydelig hvordan ting skal fungere vil gjÞre det enkelt Ä lage en sÄnn. Hvis jeg gjorde jobben min bra ville f.eks. Amazon enkelt utkonkurrere min arbeidsgiver. Dermed ble det sÄnn at min egen arbeidsgiver prÞvde Ä underminere jobben jeg gjorde pÄ alle mulige mÄter for Ä bedre sin egen konkurransesituasjon, samtidig med at de kommuniserte utad at de var sÄ Äpne. Commonswashing kalles det. Med tiden har ideen om at enkeltpersoner skal kontrollere sine egne data egentlig forsvunnet, forsÞkene pÄ Ä balansere teknologiselskapenes makt og desentralisering likesÄ.

Det som kunne ha reddet situasjonen der og da var en ny type samfunnsinstitusjon som kunne ha gÄtt inn direkte med utviklingsressurser i Þkosystemet, da kunne vi ha balansert makten direkte ved Ä ha implementasjonskapasitet, vi kunne gjort det helt klart at lukkede strategier ikke ville tolereres og vi ville visst nÄr det skjer. Politikerne er forstÄelig nok redd for Ä gjenta Quaero-fiaskoen, men den angsten bÞr ikke stoppe nye institusjoner satt opp som et selskap i reell konkurranse (man bÞr heller vÊre skeptisk til ting som European Data Spaces, som er satt opp mye likere Quaero-konsortiet). NÞkkelen er Ä skape reelle Þkosystemer, ikke Ä etablere konkurrerende plattformer. Det vi fÞrst og fremst mangler er en tilstrekkelig forstÄelse for hvordan Þkosystemene bÞr fungere, men det hjelper ikke at ingen har mulighet til Ä prÞve Ä skape dem.

SÄ lenge vi ikke har dette klart vil ikke innfÞringen av AI gÄ noe bedre. Det vi tenker pÄ som AI i dag er et ektefÞdt barn av overvÄkningsÞkonomien og ekstraktivismen. Her er det maskiner som henter ut verdier av andres arbeid. NÄ mÄ vi ikke falle i fella med sentralisering av makt igjen, fordi det vil kun styrke de samme kreftene, og jeg er redd det er dit vi er pÄ vei.

Men nĂ„r det gjelder AI, sĂ„ er det mulig jeg bare er i punkt 3 igjen. Mitt felt var nemlig i utkanten av AI-feltet, men for Ă„ forstĂ„ det litt bedre mĂ„ vi tilbake til en rekke bĂžker av Hubert Dreyfus pĂ„ 60 og 70-tallet, der han kritiserte en form for AI som antok at vi kunne ha symboler om alt og at vi kunne manipulere disse symbolene for Ă„ lage kunstig intelligens. Dagens maskinlĂŠring har til en viss grad frigjort seg fra disse antakelsene mens min retning tenkte mer “greit nok, Dreyfus hadde mye rett men hvilke nyttige ting kan vi likevel gjĂžre hvis vi bare styrker menneskeheten slik at alle kan bidra”. Jeg for min del har aldri hatt kunstig intelligens som mĂ„l (hva er intelligens anyway?), men jeg tror vi kunne gjort mye bra pĂ„ denne mĂ„ten med en veldig liten brĂžkdel av ressursforbruket som den galskapen av AI krever i dag. Jeg tror heller ikke det ressursforbruket kommer til Ă„ vĂŠre greit nok om 10 Ă„r. Jeg fĂžler at vi har lagt ned et forskningsfelt basert pĂ„ samhandlingen mellom menneske og maskin, for heller Ă„ kaste enorme mengder av jordas energi- og mineralressurser pĂ„ problemet i stedet, med lite ide om hva vi faktisk vil fĂ„ ut av det.

SÄ, hvor stÄr vi nÄ? Jeg leste en gang en diskusjon (husker ikke hvor) rundt de amerikanske tenkerne som la grunnlaget for USA, og om kontrasten mellom deres tanker om likhet mellom mennesker og viktigheten av frihet, samtidig som slaveriet var pÄtakelig fravÊrende fra diskusjonen. De manglet tilsynelatende kreativitet nok til Ä se for seg at samfunnet kunne utvikle seg uten slaveri. Man ga slavene mat sÄ de kunne bruke 100 watt til Ä opprettholde livet og dermed kunne man ekstrahere enda 100 watt arbeid. Slaveriet mÄtte oppgis pÄ moralske kvaler lenge fÞr man faktisk hadde en erstatning, men den industrielle revolusjon kom med sine maskiner og vevstoler og dampmaskiner som kunne gi langt hÞyere effekt. Det var mye som gikk galt i den industrielle revolusjon ogsÄ, men det ga lÞsninger som tenkerne 100 Är tidligere ikke kunne forestille seg.

Jeg fÞler at samfunnet er i en liknende kreativitetskrise i dag. Vi klarer ikke Ä se for oss et samfunn uten Big Tech. Vi klarer ikke se for oss et lavkarbonsamfunn heller. Og vi vÄger oss ikke utpÄ uten Ä ha alternativene klart og tydelig pÄ plass. Men fordi vi kollektivt mangler forestillingsevnen, sÄ prÞver vi heller ikke. Dystopiene er sÄ lett Ä skrive, men denne gangen Þnsker jeg ikke Ä skrive om dem, heller peke pÄ at jeg tidligere har skrevet om hva vi bÞr fÄ til.

NÄr Sagan pÄpekte at kunnskapen sitter hos de fÄ skulle jeg Þnske at jeg kunne si at det ikke er riktig. De fÄ som innehar denne kunnskapen bruker gjerne dette til Ä pÄstÄ at de har en legitim makt, deres kunnskap gir dem denne makten. Dette er en ideologi jeg tar avstand fra pÄ det sterkeste, det er nemlig den som er Ärsaken til mange av vÄre problemer. Men det er riktig at kunnskapen sitter hos de fÄ, det er ikke til Ä komme unna, og det absolutt mest kritiske vi mÄ gjÞre er Ä sÞrge for at dette ikke lenger er sant.

Problemet er tildels denne ideologien, men ogsÄ helt vanlig business strategy. Man har et rammeverk som heter VRIN/O og der bÞr man se om man kan ha noe som er sjeldent og ikke sÄ lett Ä imitere. Det er Äpenbart at programvareselskaper er kunnskapsbedrifter, og det betyr at man selvfÞlgelig sÞker Ä ha eksklusiv kunnskap. Og dermed havner kunnskapen helt naturlig hos de fÄ. Det er ingen stor konspirasjon bak det, ingen reinspikka ondskap. Bare helt vanlig business strategy. Men nÄr det betyr at kunnskapen om teknologi som skaper normer i samfunnet er i en bedrifts eksklusive eie, sÄ gÄr det galt. Da mÄ samfunnet finne en annen modell.

Og det er nettopp den modellen jeg prÞver Ä skrive om bÄde her, i kronikker og pÄ Normative Technologies. Og det er her alle trÄdene egentlig bindes sammen. Selv om vi har vÊrt ganske gode til Ä lage meritokratiske styringsmodeller for fri programvare, sÄ har vi aldri klart Ä lage styringsmodeller som faktisk gir en demokratisk forankring. SÄ her slutter altsÄ historien, for jeg er sikker pÄ at det er slik vi mÄ finne ut av for framtiden, bÄde for Ä sikre politisk styring med normdannelse og fordi vi mÄ fÄ kunnskapen ut av hendene til de fÄ. Det at Ostrom viste hvordan vi kan lage styringsmodeller gjÞr at vi i framtiden mÄ snakke om Digital Commons.

Vi blir ikke klare for Ä hÄndtere manipulasjon

Desinformasjonen vi fÄr mot oss bryr seg ofte ikke om sannhet. Derfor er vi ikke forberedt pÄ fÞlgende av generativ KI og det ser veldig dÄrlig ut nÄ. NÄr formÄlet med desinformasjon er Ä Þdelegge vÄr evne til Ä skille sannhet fra lÞgn, stÄr vi langt mer forsvarslÞse enn det KI-ekspertene forteller oss og de som mener de har lÞsninger, har sannsynligvis ikke forstÄtt problemet.

Jeg merket det allerede i 1996, da jeg startet hjemmesidene til foreningen Skepsis: Gal informasjon spredte seg langt raskere enn det noen klarte Ä mÞte. Informasjon som appellerte til sterke fÞlelser spredte seg raskest. Det handlet aldri om Ä nÄ ut til folk med riktig informasjon, det handlet om Ä nÄ inn i lukkede sinn, sinn som var lukket fordi de hadde en fortelling i hodet. Men jeg jobbet ikke sÄ mye mer med det da, tok etterhvert ph.d. i informatikk i utkanten av KI-feltet og har jobbet mest i norsk og internasjonal IT-industri. I det siste har jeg jobbet med Ä etablere andre styringsformer for teknologiutvikling. I den forbindelse har jeg arbeidet litt med informasjonsforurensning inn mot FN-systemet.

Flood the zone with shit

Donald Trumps tidligere sjefstrateg Steve Bannon har forklart at hans strategi er Ă„ “flood the zone with shit”. AltsĂ„, mĂ„let er ikke Ă„ overtale noen ved Ă„ pĂ„peke fakta, men Ă„ sĂžrge for at folk ikke klarer Ă„ skille sannhet fra lĂžgn. Men Bannon var slett ikke den som fant pĂ„ strategien, dette gjorde Putin fĂžr ham, og Stalin fĂžr ham igjen.

Filosofen Harry Frankfurt forklarte i sin bok “On Bullshit” at bullshit er utsagn der avsenderen ikke bryr seg om utsagnet er sant eller usant. Generativ KI er nettopp dette: Bullshit-maskiner. Det er bare ord eller bilder satt sammen med en sannsynlighet for at de hĂžrer sammen uten en tanke for sannhet. Generativ KI passer som perfekt i hendene pĂ„ aktĂžrer som ikke bryr seg om sannhet fordi teknologien driver prisen pĂ„ bullshit mot null.

NĂ„r Inga StrĂŒmke uttaler til NRK at “Hvis vi blir skeptisk til troverdigheten i hva vi ser, sĂ„ er det bare sunt.” sĂ„ er det en alvorlig misforstĂ„else. Dette er ikke sunn skepsis, dette er en nihilistisk skeptisisme som Ăždelegger vĂ„rt felles grunnlag for Ă„ avgjĂžre hva som er sant. Dette er kognitiv krigfĂžring.

Det handler om fortellinger

Ekstremismeforskeren Ajit Maan argumenterer for at problemet ikke er desinformasjonen i seg selv, men at informasjon mÄ passe inn i en fortelling for Ä gjÞre inntrykk, og desinformasjonen er farlig fordi den passer inn i en fortelling man allerede har om seg selv.

NÄr SÞlve Kuraas Karlsen forteller at vi skal vÊre sammen med mennesker som spÞr hvor informasjonen kommer fra, og selv spÞrre etter kilder, sÄ tar det ikke inn over seg betydningen av fortellinger for mennesker.

Nettverk av bullshit

Men det blir enda verre nÄr han snakker om Ä bruke flere kilder. Snart vil generativ KI lage store nettverk av bullshit som peker pÄ hverandre, for Ä gi inntrykk av et stort system av fakta.

Veien til nettverket er brolagt med personlige data. Med data fra sosiale medier og annonsesystemer vil systemet lage fortellinger som er tilpasset den enkeltes fortellinger. Karlsens utrustning vil vĂŠre fullstendig ineffektiv.

Systemene er sikkert under utvikling

Etter at Libya falt sammen har en hÄndfull oljebaroner sett seg best tjent med at det ikke blir noen effektiv statsdannelse i landet. De har nok penger og bruker dem pÄ Ä utvikle systemer for Ä spre bullshit i samfunnet. Libya kan bli en viktig leverandÞr av slik teknologi til autokrater og personer som vil brenne institusjonene. Vi mÄ regne med at store penger brukes pÄ dette mange steder i verden.

Sannsynligvis blir disse vÄpnene nÄ opplÊrt til Ä komme seg rundt tek-gigantenes systemer for Ä detektere desinformasjon. Jeg var blant dem som fikk se en Lego-svindel pÄ Facebook. Da jeg begynte Ä undersÞke mer rundt svindelen fant jeg et stort et nettverk av flere hundre falske kontoer. Hver av de falske kontoene sÄ ut til Ä ha en KI-generert falsk livshistorie og falske bilder. Dette handler om utvikling av vÄpen, ikke en simpel svindel.

Industriens dominans mÄ brytes

Som teknolog har jeg lenge innsett at vi ikke har noen teknologi som kan hjelpe med dette pĂ„ kort sikt. Jurister og medievitere mĂ„ ogsĂ„ innse at lov og “media literacy” ikke vil fare stort bedre. Det skjer en kollaps av vĂ„rt felles kunnskapsgrunnlag og offentlige sfĂŠre akkurat nĂ„. I en verden med atommakter i krig, og der klimaendringer er i ferd med Ă„ Ăždelegge livsgrunnlaget for mange mennesker kan dette fĂ„ katastrofale konsekvenser.

Vi har ikke makt til Ä styre teknologiutviklingen i dag, og vi mÄ skaffe oss det, samtidig som vi gjÞr det aller fÞrste steget: Ingen mÄ ha kontroll over dataene som kan brukes til Ä mÄlrette fortellinger mot personer. Det er den aller farligste delen. Vi kan gjÞre det ved Ä opprette tverrfaglige samfunnsinstitusjoner som utvikler teknologi med et demokratisk mandat. Og ikke gi opp hÄpet.

Hvorfor algoritmetilsyn ikke vil virke og hva vi bĂžr gjĂžre i stedet

Året er 1991 og skolen min har i lĂžpet av sommeren fĂ„tt mange fine PCer pĂ„ datarommet. Men, data-lĂŠreren min er frustrert, det er allerede langt utpĂ„ hĂžsten, og den andre data-lĂŠreren pĂ„ skolen som har ansvaret for Ă„ installere anti-virus pĂ„ maskinene har ikke gjort det. En dag kommer lĂŠreren vĂ„r til meg og en kamerat og sier “gutta, kan dere gjĂžre noe for Ă„ fĂ„ satt fart i han andre fyren?”

Joda, det skulle det vel bli en rÄd med. SÄ, han lÄste oss inn pÄ datarommet i en midt-time, og pÄ den tiden gjorde vi et aldri sÄ lite hack. Vi lagde et program som gjorde at etterhvert som man skrev pÄ tastaturet tok det lenger og lenger tid fÞr maskinen oppfattet tastetrykkene. FÞrst var det nesten umerkelig, men nÄr man hadde skrevet 1000 tegn var forsinkelsen ett sekund, og da var det allerede blitt veldig plagsomt. SÄ erstattet vi et av programmene som maskinen startet automatisk nÄr den ble slÄtt pÄ, og passet pÄ Ä legge inn mye uvirksom kode som gjorde vÄrt program tilforlatelig likt det vi erstattet, som ble kjÞrt etterpÄ.

I dag ville dette lett blitt oppdaget av anti-virus og “intrusion detection environments”, men datidens anti-virus var avhengig av Ă„ kjenne igjen kjente mĂžnstre, og klarte ikke Ă„ gjenkjenne programmet vĂ„rt, sĂ„ det ble aldri oppdaget. Men det virket etter sin hensikt, maskinene ble re-installert med anti-virus, og vi fikk en high five fra lĂŠreren vĂ„r, men meg bekjent er det fĂžrste gang historien fortelles.

Og grunnen til at jeg forteller den nÄ er at EU legger opp til et omfattende inspeksjon og revisjons-regime i flere deler av sin lovgivning, og her hjemme har flere gÄtt inn for et algoritmetilsyn for Ä sÞrge for at teknologiselskapene fÞlger lovgivningen. Jeg er positiv til tilsynsfunksjoner, men jeg er ganske sikker pÄ at hvis et teknologiselskap prÞver Ä skjule sine svin pÄ skogen, sÄ vil ikke et slikt tilsyn kunne oppdage det.

Eksempel pÄ en algoritme

Det skrives mye om algoritmenes makt, men ofte fÄr jeg pÄ fÞlelsen at mange ikke helt vet hva det er. Det er ikke sÄ vanskelig, vi kjenner alle sammen noen algoritmer, vi lÊrer dem til og med pÄ barneskolen. Ta for eksempel hvordan man legger sammen to heltall. Vi setter tallene opp over hverandre, ikke sant?

Og sÄ begynner vi bakerst, og legger sammen sifferne pÄ enerplassen. Hvis den resulterende summen er stÞrre eller lik 10, deler vi opp tallet, og tar det bakerste sifferet, det blir resultatet pÄ enerplassen, mens 1-tallet fÞrst legges sammen med summen av sifferne pÄ tierplassen. Og sÄ gjÞr vi det samme igjen og igjen helt til det ikke er flere tall igjen Ä legge sammen.

SÄ, det er et eksempel pÄ en algoritme vi stadig bruker i hoderegning. For at en datamaskin skal kunne hjelpe oss med utregningen, mÄ dette oversettes til et sprÄk datamaskinen forstÄr. NÄ er det sÄnn at jobben gjÞres av den fysiske prosessoren din, men nÄ skal vi late som vi mÄ gjÞre dette selv. Snart kan det hende sprÄkmodeller kan gjÞre denne jobben ogsÄ, men forelÞpig lar vi det gÄ igjennom noen skritt, der vi skal se pÄ det fÞrste. Det er mange programmeringssprÄk Ä velge mellom, men jeg skal bruke JavaScript, fordi det kjÞrer i alle nettlesere.

En ĂŠrlig heltallskalkulator

Her er det en enkel kalkulator. Den tar bare heltall og kan bare plusse to tall, men den bruker en implementasjon av algoritmen vÄr:


+
=

Bare prÞv den! Se at den funker! La oss se pÄ den faktiske koden som kjÞrer i dette tilfellet. Hvis du ikke er vant til Ä se pÄ kode, er det helt greit, jeg skal forklare under.

function run1()
{
	var ledd1 = document.getElementById("f1part1").value;
	var ledd2 = document.getElementById("f1part2").value

	var alle_siffer1 = ledd1.split('');
	var alle_siffer2 = ledd2.split('');

	var resultat;

	var siste1 = parseInt(alle_siffer1.pop());
	var siste2 = parseInt(alle_siffer2.pop());

	while ((! isNaN(siste1)) || (! isNaN(siste2))) {
    	if (isNaN(siste1)) {
        	siste1 = 0
    	}	
    	if (isNaN(siste2)) {
        	siste2 = 0
    	}
    	var del_resultat = siste1 + siste2;
    	siste1 = parseInt(alle_siffer1.pop());
    	siste2 = parseInt(alle_siffer2.pop());
    	if (del_resultat >= 10) {
        	del_resultat = del_resultat.toString().split('').pop();
        	siste1 = isNaN(siste1) ? 1 : siste1 + 1;
    	}

	    resultat = [del_resultat, resultat].join('');

	}
    
	document.getElementById("f1answer").value = resultat;
}

AltsĂ„, alt er i en funksjon som kjĂžres nĂ„r du trykker “regn ut”. Linje 3 og 4 henter teksten (formodentlig tall) du har skrevet inn, og gir dem et navn. Linje 6 og 7 deler dem opp. Linje 9 gjĂžr bare klar for Ă„ ta vare pĂ„ resultatet. Linje 11 og 12 er den egentlige starten pĂ„ algoritmen vĂ„r, der tar vi det siste tegnet fra teksten du skrev inn og gjĂžr dem om til et ordentlig heltall, ikke bare en tekst. Og sĂ„ begynner vi pĂ„ runden i linje 14, altsĂ„ “sĂ„ lenge det finnes noe som ikke er ikke et tall pĂ„ en av leddene…”. Det er nĂ„ man mĂ„ holde tunga rett i munnen. I linjene 15-20 sjekkes det om vi har et tall. Hvorfor mĂ„ vi gjĂžre det? Jo, fordi tallene du skrev inn kan ha forskjellige lengde (og ja, ting kan gĂ„ veldig galt her). Og sĂ„ legger vi sammen de to sifferene i linje 21, fĂžr vi igjen i 22 og 23 gjĂžr om neste tegn til et tall. Linjene 24-26 passer pĂ„ at vi fĂ„r med tier-overgangen. Linje 29 lager igjen en tekst av resultatet, og linje 33 sender det tilbake til skjemaet over.

OK, sÄ vi ser at det var ganske mye mer involvert i Ä implementere algoritmen enn Ä skrive den pÄ prosa. Mye mer tunga rett i munnen, og mange flere steder man kan gjÞre feil. NÄ vil man jo ikke skrive akkurat denne algoritmen i praktisk bruk, men man mÄ passe pÄ mulige feilsituasjoner. Man mÄ ogsÄ ta hÞyde for om brukeren er dum eller slem, og skriver bokstaver i stedet for tall. Koden over gjÞr ikke den delen av jobben. Og det er koden som kjÞrer, ikke algoritmen som skrives kan skrivers pÄ prosa. SÄ, det er hovedsakelig koden det mÄ fÞres tilsyn med, ikke bare algoritmen.

Legg til en dĂŠsj ondskap

OK, sÄ hva om vi gjÞr dette:

function run2()
{
	var ledd1 = document.getElementById("f2part1").value;
	var ledd2 = document.getElementById("f2part2").value

	var alle_siffer1 = ledd1.split('');
	var alle_siffer2 = ledd2.split('');

	var resultat;

	var siste1 = parseInt(alle_siffer1.pop());
	var siste2 = parseInt(alle_siffer2.pop());

	while ((! isNaN(siste1)) || (! isNaN(siste2))) {
    	if (isNaN(siste1)) {
        	siste1 = 0
    	}	
    	if (isNaN(siste2)) {
        	siste2 = 0
    	}
    	var del_resultat = siste1 + siste2;
    	siste1 = parseInt(alle_siffer1.pop());
    	siste2 = parseInt(alle_siffer2.pop());
    	if (del_resultat >= 10) {
        	del_resultat = del_resultat.toString().split('').pop();
        	siste1 = isNaN(siste1) ? 1 : siste1 + 1;
    	}

	    resultat = [del_resultat, resultat].join('');
		if (resultat == '42') {
			resultat = 17;
		}
	}
    
	document.getElementById("f2answer").value = resultat;
}

Hva har skjedd her, sÄnn bortsett fra at noen navn har fÄtt tallet 2 der det forrige eksemplet hadde 1? Jo, se pÄ linje 30-32. Jeg har lagt inn kode som gjÞr at nÄr svaret skulle vÊrt 42, sÄ blir det 17 i stedet. Bare prÞv det selv, legg inn noe som blir 42 til sammen:


+
=

Den som skriver koden har makta! Man kan manipulere brukeren pÄ alle mÄter, man kan underminere brukerens tillit (denne koden kjÞrer faktisk pÄ din enhet), og man kan manipulere andre som vekselvirker med et system. Det er helt avgjÞrende Ä forstÄ hva man kan stole pÄ og hva man ikke kan stole pÄ.

Det blir egentlig bare verre. PrĂžv Ă„ la et av tallene du skriver inn ha et 7-tall i seg. Hva skjedde nĂ„? Jo, hver eneste linje i programmene du ser kan gis en annen mening enn du forventer. I dette tilfellet har jeg overstyrt funksjonen som konverterer tegnene du skriver inn til heltall, og gjort at den trekker fra litt… Jeg introduserte altsĂ„ en systematisk feil.

Systematiske feil lagt inn med vilje

Det er varierende hvor lett det er sÄ skjule slik ondskap. I JavaScript er det faktisk ikke sÄ lett, men det kan vÊre gode grunner til at det kan vÊre lett. Mekanismer for Ä skjule slike ting kan ogsÄ gjÞre koden mer lesbar.

I 1984 fikk Ken Thompson Turing-prisen, “informatikkens nobelpris”. I sitt foredrag presenterte han en kort artikkel med tittel “Reflections on Trusting Trust”. Det er en artikkel man kan brekke hjernen sin pĂ„, og jeg har ikke forstĂ„tt detaljene, men han viser en teknikk for Ă„ skjule en bakdĂžr inn i kode som er veldig, veldig vanskelig Ă„ oppdage. I koden over, er alt helt oppi dagen, jo dypere man kommer, jo vanskeligere er det Ă„ oppdage. Det vil ikke vĂŠre vanskelig Ă„ lage en bakdĂžr som kun et lite antall i selskapet kjenner til hvis man har et stort system.

Siden Thompons artikkel har man utviklet en rekke teknikker for Ä verifisere at koden ikke gjÞr skumle ting, men spÞrsmÄlet er om det holder. Angrepsformen er ogsÄ modernisert til Ä gjelde moderne maskinlÊring.

Jeg skal innrÞmme at dette ikke er helt mitt felt, men nÄr man fÞrst tenker som meg, sÄ tenker man alltid pÄ mulige angrep. Vi mÄ skille mellom situasjonen der de som skaper teknologien er snille og angriperne kommer utenfra, fra situasjonen der selskapet som skaper teknologien er den som prÞver Ä fÞre folk bak lyset. Spesielt nÄr det er en mer ressurssterk organisasjon som har langt dypere kunnskap om systemet. Jeg tror vi skal klare Ä hÄndtere den fÞrste situasjonen og fÄ tilstrekkelig sikkerhet der. Men i de siste tilfellet tror jeg ikke tilsynsmyndighetene kommer til Ä ha sÊrlig stor suksess.

Volkswagens Dieselgate

Vi har vĂŠrt borti en slik situasjon for litt siden. Allerede i 2011 oppdaget EU at Volkswagens dieselbiler hadde altfor store emisjoner, og advarte mot “defeat devices”, altsĂ„ systemer som kunne lure testen som ble brukt til Ă„ mĂ„le avgassene. Etter at flere hadde sett det samme, slo bĂ„de europeiske og amerikanske myndigheter det fast i 2015 at det fantes systemer i bilene som lurte testen. FĂžrst i 2017 klarte forskere Ă„ finne den faktiske koden. Dette tok dem et helt Ă„r, pĂ„ tross av at de hadde tilgang til koden, og det ikke var brukt noen avanserte teknikker, bare at den brukte andre navn om hva den gjorde enn hva som faktisk skjedde.

Man mÄ gjÞre aktivt review

Dette illustrerer hvor vanskelig det er Ă„ komme inn i kode og se etter ugler i mosen. Det er svĂŠrt vanlig at man har utviklingsprosesser der man gjĂžr kontinuerlig “review” av all kode fĂžr den gĂ„r inn i kodebasen. Å gjĂžre review innebĂŠrer at man gĂ„r gjennom ny kode og gjĂžr seg selv sikker pĂ„ at man forstĂ„r hva den gjĂžr. Ofte vil et ordentlig review gjĂžre at man skriver en lengre tilbakemelding og ber om stĂžrre endringer. Man utsetter den ogsĂ„ for automatiske tester slik at man vet godt hva koden gjĂžr. Jeg har selv bĂ„de gjort review, lagd rammeverk for automatiske tester og skrevet en masse tester. Jeg liker Ă„ skrive tester fĂžrst for Ă„ vĂŠre sikker pĂ„ at jeg forstĂ„r hva koden skal gjĂžre. Min erfaring er at for Ă„ kunne gjĂžre et godt review bĂžr man vĂŠre involvert i koden jevnlig, helst pĂ„ daglig basis. Hvis man skal kunne oppdage at noen gjĂžr slemme ting og prĂžver Ă„ skjule det, sĂ„ er det helt nĂždvendig at man er inne pĂ„ daglig basis, og helst ikke bare ved Ă„ gjĂžre review, man bĂžr aktivt utvikle i systemet. Du bĂžr gjĂžre review av andres kode, og de bĂžr gjĂžre review av din, og alt mĂ„ testes hele tiden, og man mĂ„ ha automatiserte tester for alt. Bare slik fĂ„r man god kode. Bare sĂ„ god kode og slik praksis vil kunne gjĂžre at tilsynsmyndigheter har en sjanse. Skulle europeiske tilsynsmyndigheter gjort denne typen review, mĂ„tte man ha titusenvis av ansatte. Selv da er det et spĂžrsmĂ„l om man klarer Ă„ ha nĂždvendig avstand mellom utvikler og revisor, nĂ„r disse mĂ„tte jobbe sammen til daglig.

Sorte svaner og overflatekonsekvenser

I likhet med dieselgate kan man gjĂžre inspeksjon ved ikke bare Ă„ sjekke kode, men ogsĂ„ sjekke hvilke konsekvenser koden har. I dieselgate oppdaget man fĂžrst altfor store emisjoner. Det er et meget stort felt som driver med dette, og man utvikler “benchmarks” som skal prĂžve Ă„ identifisere mulige problemer. Jeg mener denne tilnĂŠrmingen har ganske lite for seg, det kan vĂŠre helt andre ting som er problematisk enn det man forestilte seg da man lagde benchmarken. Benchmarking er sjelden god vitenskap. Man kan ikke bevise at det ikke finnes en julenisse pĂ„ nordpolen med et reinsdyr som har rĂžd nese, og slik kan man aldri vĂŠre sikker pĂ„ at man har truffet den faktiske skurkestreken. Man kan heller ikke slutte av at alle svaner er hvite selv om man aldri har sett noe annet.

Kunnskapsskjevhetens betydning

Det er klart at en tilsynsmyndighet kan komme inn og sjekke at man fĂžlger god praksis. Man kan bruke moderne teknikker for Ă„ prĂžve Ă„ kryptografisk sikre at koden man ser er den som faktisk kjĂžres. I en situasjon der man har balanse mellom kunnskapen tilsynsmyndighetene besitter og teknologiselskapene besitter kan det kanskje hende det kunne fungert.

Det er enklest Ä lage en forretningsmodell hvis man har eksklusivitet. Du mÄ ha en konkurransefordel, noe som ikke konkurrentene dine har. SÄ, mesteparten av IT-industrien er bygd rundt det, og det man som oftest har eksklusivitet pÄ er faktisk ikke selve programvaren, men kunnskapen som er bygd inn i den programvaren. Det er ikke alltid problematisk, men det blir veldig problematisk nÄr den programvaren setter normer for hvordan samfunnet vÄrt fungerer. Da blir det giftig fordi da er det teknologiselskapet som bestemmer normene, uten demokratisk mandat. Det er etter min oppfatning hovedgrunnen til at teknologiutviklingen har gÄtt sÄ galt. Kunnskapsskjevhet er et grunnlagsproblem, ingen tilnÊrminger som ikke lÞser dette problemet vil ha Þnsket effekt.

SÄ, vi er veldig langt fra en situasjon der det er balanse mellom myndigheter og selskaper. Vi er veldig, veldig langt fra det. Inspeksjon- og revisjonsregimet er ikke lÞsningen pÄ dette problemet, selv om EU later til Ä tro det. Dette er problemet som mÄ lÞses fÞr tilsynsmyndigheter kan ha betydning. SÄ hvordan gjÞr vi det?

Den digitale allmenningen er redningen

Det finnes en annen mÄte Ä utvikle programvare og standarder pÄ. Den utgjÞr faktisk det meste. Det er basisen for Android og iOS, for webservere og datasentre, og for maskinlÊring. Den bestÄr ogsÄ av nesten alle standardene som brukes i ditt dagligliv, og man finner mye Äpne data i den. Den digitale allmenningen er flere tiÄr gammel og er stor og innovativ.

Vi som jobber i den digitale allmenningen har deling av kunnskap som det viktigste vi gjÞr, det er hvem vi er. Vi tilbyr transparens, inklusivitet, selvbestemmelse, bruksrett og mulighet til Ä bidra og til Ä direkte pÄvirke hva teknologien gjÞr. Utviklingen gjÞres i Äpne miljÞer med flere aktÞrer, noen ganger konkurrenter.

I allmenningen har vi kjente metoder for omfattende review og testing. Ta en titt pÄ endringsloggen til Linux for eksempel, der personer fra flere selskaper tester og gjÞr review av koden. Man kan for eksempel se at en ansatt i AMD gjÞr review av et endringsforslag gjort av en ansatt i Intel. Intel og AMD er to av verdens stÞrste produsenter av prosessorer, og er hverandres hovedkonkurrenter. NÄr hver kodebit gjennomgÄr en slik prosess blir det ikke bare svÊrt vanskelig Ä snike inn noe, man fÄr en ordning som skalerer, det er et helt miljÞ som sÞrger for at koden ikke inneholder ting som ikke skulle vÊrt der, ikke bare en tilsynsmyndighet med begrensede ressurser. NÄr kommersielle konkurrenter har gjensidig nytte av Ä sikre god forvaltning av kode oppstÄr det gode effekter for samfunnet som helhet, det er nettopp det allmenninger handler om.

Men ikke alt er rosenrÞdt i den digitale allmenningen heller. Man ser at mennesker brenner seg ut, man ser at den er underfinansiert (og det er nok fordi det er vanskeligere Ä finne gode forretningsmodeller), man ser at man ikke klarer Ä organisere god nok testing og review og dermed blir sikkerhetsfeil gÄende uoppdaget, og man ser ogsÄ at selskaper prÞver Ä bygge gjerder som Þdelegger. Det er derfor fortsatt behov for en tilsynsmyndighet, men den kan vÊre mye mindre enn det som vil vÊre nÞdvendig i EUs regime. Den mÄ sÞrge for at prosjekter som har betydning for normene i samfunnet har en god maktbalanse mellom aktÞrene, og hvis det ikke gjÞres god nok review og testing, sÄ mÄ man sÞrge for at det blir satt inn tilstrekkelig med ressurser til Ä gjÞre det. Det kan gjÞres ved Ä finansiere noen av aktÞrene slik Tyskland gjÞr med sitt Sovereign Tech Fund og som nÄ er i ferd med Ä bli generell EU-politikk.

Enda bedre, mener jeg, er om man setter opp en ny type samfunnsinstitusjon, som skal utvikle programvare med et demokratisk mandat snarere enn et kommersielt mandat. Jeg har kalt en slik institusjon “Senter for normativ teknologiutvikling”. Demokratiet vil bruke en slik tverrfaglig institusjon til Ă„ direkte pĂ„virke normene som settes gjennom teknologien. Å utfĂžre review og testing og sette inn ressursene som gir maktbalanse er blant de operative tingene en slik institusjon vil gjĂžre, men den vil fĂžrst og fremst vĂŠre skapende. Tilsynsmyndigheten vil fortsatt ha et overordnet ansvar for sĂžrge for at allmenningen blir godt forvaltet.

Tillit er fortsatt det beste

Jeg vil ikke ha Big Tech-selskapene i det norske samfunnet. De har sÄ til grader brutt ned tilliten, bÄde min egen tillit til dem og den tilliten samfunnet bÞr ha til dem. Vi bÞr ikke ha slike selskaper som opererer i vÄrt samfunn. NÄr tilliten er brutt er det lett Ä Þnske seg et veldig omfattende inspeksjon- og revisjons-regime, men det EU legger opp til vil aldri kunne bygge opp tillit, det vil kun bidra til at Big Tech fÄr operere omtrent som fÞr, bare under en solid mengde papirarbeid.

Men likevel, de nordiske tillitssamfunnene er fortsatt de beste. At vi har sterke tilsynsmyndigheter er en viktig Ärsak til at vi har slike tillitssamfunn, men vÄre tilsynsmyndigheter driver ikke med tilsyn for papirarbeidets skyld, de er faglig sterke myndigheter som leverer ordentlige resultater. Det regimet som vil oppstÄ hvis kunnskapsskjevheten mellom industri og reguleringsmyndigheter bestÄr mÄ ikke forveksles med det norske tilsynsmyndigheter gjÞr i dag.

Jeg er sjelden blant dem som er redd for at innovasjon blir skadelidende ved innblanding av offentlige myndigheter. Men jeg tror at det kan bli mindre innovasjon av et slikt regime, mens innovasjonsevnen vil Ăžke sterkt hvis det offentlige bidrar til utviklingen av digitale allmenninger gjennom et “Senter for normativ teknologiutvikling”. Jeg sier et stort ja takk til offentlig innblanding hvis det gjĂžres pĂ„ riktig mĂ„te.

Siden digitale allmenninger er radikalt Äpne, vil disse kunne opparbeide seg tillit pÄ en mÄte som lukkede teknologiselskaper aldri kan fortjene, og dette vil gjÞre at vi kan ha en nordisk tillitsmodell til selskapene som utvikler i allmenningen. Det inkluderer ogsÄ Big Tech. Noe slikt kan ikke EU fÄ til, men nordiske land kan.

Konklusjon

Det er en stor kunnskapsskjevhet mellom industri og reguleringsmyndigheter i IKT-feltet, noe som gjÞr at et inspeksjon- og revisjonsregime ikke vil fungere, det er altfor lett Ä skjule hva kode faktisk gjÞr. Et algoritmetilsyn vil fÞre tilsyn med feil ting, og vil ikke fÄ betydning for de faktiske problemene. I stedet fÄr vi ineffektiv teknologiutvikling og mange offentlige ansatte som ikke bidrar til nyskaping.

I stedet mÄ myndighetene sÞrge for at teknologi som setter normer utvikles i Äpne miljÞer, slik mye programvare allerede gjÞr. Dette mÄ skje i digitale allmenninger. Ved Ä gjÞre dette vil befolkningen kunne ha tillit til teknologiutviklingen, og vi vil fÄ offentlige ansatte som bidrar direkte i verdiskaping og innovasjon, og fÄ fart pÄ bÊrekraftig innovasjon i nÊringslivet.

Provenance as key technology to reduce information pollution

To verify the veracity of information, the authenticity and authoritativeness of that information is important to assess. Tracking the origins of information is important to understand its authenticity and authoritativeness. So far, authenticity and authoritativeness has largely been assessed only by understanding the content itself and has been the focus of media literacy programmes. However, information pollution has made it increasingly difficult for non-experts to assess the authenticity and authoritativeness of information, a problem that is likely to become worse. This document introduces the concepts and discusses existing efforts and finally outlines the commitment needed from governments.

Introduction

The term provenance is commonly used in technical literature to describe the practice of tracking who and what not only originates information, but who and what changes it. Conventionally, provenance is metadata that follows the information.

Consider an image, shot by a certain camera by a certain person. The camera information and an identifier of the photographer should in most cases be available as provenance metadata. Consider then the possibility that the image is photoshopped, then at least information that it has been photoshopped and by whom should be added. If the image is then published in social or editor-run media, the provenance information should be checked to see if it is likely consistent with the content of the image.

To allow citizens to assess the authenticity and authoritativeness of the information, there should usually be tools that can help them verify the correctness of the provenance metadata. Usually, the public should realize that information that comes with verifiable provenance metadata is more trustworthy than information without. However, this is clearly not desirable in all cases, in some cases that metadata is highly sensitive. In the case where the information comes from a whistleblower, it must be removed. In such cases, free editor-run media is important, as they can assess the veracity of the information, and the public would then need to rely on the reputation of the media to assess the trustworthiness of the information.

Recommended reading and existing initiatives

Henry Story has written quite extensively on the role of provenance in his work on Epistemology in the Cloud. In an OpenAI-sponsored paper titled Generative Language Models and Automated Influence Operations: Emerging Threats and Potential Mitigations the authors describe the outcome of a symposium where potential mitigations were discussed. Provenance was discussed in the paper, noting that

Because technical detection of AI-generated text is challenging, an alternate approach is to build trust by exposing consumers to information about how a particular piece of content is created or changed.

They also reference a prominent technical approach by industry actors that has formed the Coalition for Content Provenance and Authenticity (C2PA), and has produced technical specifications including an harms modelling overview.

An earlier, and more academic standardization effort was undertaken under the auspices of the World Wide Web Consortium to produce the PROV family of documents. It did not see very extensive implementation, but I have used it to provide an unbroken chain of linked provenance data from individual changes to my own open source contributions through my packaging and to Debian packages. Unfortunately, the data sources this relied on are now defunct.

Nevertheless, it is clear that the main challenges are not technical. Conceptually, it is quite well understood and if it is done on a large scale, it could have a significant impact. It is therefore much more important to discuss the implications for how technology is governed.

Normative Technology Development

Whatever technology choices are made in this area will set down societal norms. This illustrates a crucial point that not only law sets norms in the form of regulation. There are also cultural, religious and biological norms, and also technological norms. As the C2PA coalition analyzed harms, they made choices as to what should be considered a potential harm, and in designing a system, those choices informed the technical decisions that they made, and thus formed norms. This is not to say that the choices that they made were wrong, but they are to a great extent political choices that should have been influenced by elected representatives.

Now, given that they sport significant implementation capacity, it makes sense that the companies that form this coalition to have a representation too, but it should have been balanced by other participants that have a democratic mandate. For these participants to have an impact, they must too have implementation capacity so that they can demonstrate that the solutions proposed by those with a democratic mandate can be implemented and have an impact.

Doing this in open ecosystems with non-exclusionary terms so that they become Digital Commons are essentially what I refer to as normative technology.

With a strong public engagement, democratic institutions will also gain knowledge into the details of the technology, which will also greatly assist lawmakers as eventually these norms may be written into law. Moreover, democratic institutions will need to assist in the dissemination of the technology throughout society, as this is probably the most difficult obstacle for provenance technology to have societal impact.